
片元着色
需要预先学习:
- 算了别看了,前面的都得学
1. 片元着色
我们在 光栅化 阶段得到了 片元,片元本身会携带顶点经过插值后的属性,但是这些属性距离最终显示的像素颜色还有一段距离。片元着色器(fragment shader)就是在这个阶段对片元进行处理,计算出最终的结果(与 顶点着色器 一样,我们需要的结果并不一定是颜色)。
也有人将片元着色器(fragment shader)称为像素着色器(pixel shader),但是严格来说片元与像素并不等价(详见 片元)。笔者认为"片元着色器"这个叫法更为恰当,因此本博客统一使用"片元着色器"。
前面的几篇处理的对象都不太一样:变换、投影处理的是顶点的坐标,图元装配与裁剪处理的是三角形本身,光栅化处理的是"哪些像素被覆盖"。到了片元着色,处理的对象变成每个被覆盖像素上的一个片元,它不再改变几何的形状,也不改变覆盖关系,只负责给这个片元算出一组值。
那么,片元着色的核心问题有两个:每个片元要算出什么值,以及这些值最终写到哪里去。
1.1 片元着色器
片元着色器(fragment shader)是运行在 GPU 上、由应用程序提供、为每个片元执行一次的小程序。光栅化每覆盖一个像素就产出一个片元,GPU 就把这个片元交给片元着色器的 main 跑一遍。它是 可编程着色器 的一种,和顶点着色器的分工可以用下表对照:
| 项目 | 顶点着色器 | 片元着色器 |
|---|---|---|
| 执行次数 | 每个顶点一次 | 每个片元一次 |
| 必须输出 | 裁剪空间位置 | 通常没有硬性要求 |
| 决定的事 | 几何落在屏幕的哪里 | 该像素位置显示成什么值 |
| 数量级 | 几何量级 | 像素量级,通常远多于顶点 |
1.2 输入
片元着色器能读到的数据有四类,来源各不相同:
| 来源 | 内容 | 例子 |
|---|---|---|
| 光栅化插值 | 顶点属性按 重心坐标 摊到片元的位置上 | 颜色、法线、UV、世界坐标 |
| 片元自身 | 屏幕坐标与深度,光栅化直接给出 | 像素中心坐标、 的深度 |
| 应用侧传入 | 整次绘制共用、与具体图元无关的只读参数 | 光源位置与强度、材质参数、相机位置 |
| 图像资源 | 可以按坐标查询的图像 | 颜色贴图、法线贴图 |
插值属性
第一类数据来自光栅化阶段的属性插值,用的是 光栅化 给出的公式:
其中 是片元位置的重心坐标。透视投影下屏幕空间与视图空间的间距不成比例,直接插值会把远处"拉平",所以硬件实际插值的是 与 ,到片元里再相除。
插值结果只是三个顶点值的加权平均,不是表面上"真实"的量,用之前要注意两件事:
- 法线必须重新归一化。三个单位向量的加权平均,长度一般小于 1,直接用会让光照整体偏暗;
- 深度不需要校正。 是 的仿射函数,而 在屏幕空间本身就是线性的,所以直接线性插值得到的就是准确值,光栅化可以把深度与前几类属性一起直接插值出来。
对于整数、物体 ID 这类不能被平均的量,插值没有意义,需要让整个图元取同一个值传下来。常见的实现方法是在顶点着色器中把值放在一个约定好的顶点上,光栅化阶段不做插值。
屏幕坐标与深度
片元自身携带窗口坐标:、 是 视口 变换后的屏幕坐标, 是视口变换把 NDC 的 从 拉到深度范围之后的结果,一般就取 。
屏幕坐标可以定位到具体的像素:按 顶点、图元与屏幕映射 的约定,索引为 的像素覆盖 ,中心点是 。所以片元拿到的 、 通常带 0.5 的小数部分。屏幕空间的效果、深度的可视化都要用它。
应用侧传入
剩下两类是"常数"与"图像"。常数指整次绘制不变的东西:光源位置与强度、材质参数、相机位置、时间。图像则按坐标查询,典型用法是用 UV 去取一张贴图里的颜色。它们由应用程序在绘制前准备好,着色器只负责读。
1.3 输出
片元着色器的输出是这个片元经过运算后的一组数据,数据的具体格式可以由程序编写者指定:
- 最常见的是一个颜色(RGB 或 RGBA),交给后面的混合与显示;
- 也可以一次输出多组值,按编号写进多个颜色附件(G-Buffer 就是这样,一次画出法线、深度、材质参数);
- 输出的值不一定真写进缓冲。后面还有模板测试、深度测试、混合,任何一关不通过,这个值就被丢掉;
- 编号对应的附件没有绑定,写了也白写。
颜色不是片元着色器的义务。渲染阴影图、做深度预通道时,帧缓冲里只挂着一张深度图,根本没有颜色附件;此时片元着色器可以什么都不输出,只要让片元通过深度测试、把深度写进去就够了。Vulkan 在开启光栅化时要求管线里必须存在一个片元着色器阶段,但它可以零输出;D3D12 允许管线里干脆不放片元着色器,效果一样——"有片元着色器"与"必须输出颜色"是两件事。
另外要区分两种"没写":声明了输出却不赋值,写进附件的是未定义值,画面可能随机花屏;干脆不声明输出,对应附件不会被修改,内容保持原样。
片元着色器还能丢弃片元:某个条件成立时让这个片元彻底消失,不进入后续测试,也不写任何缓冲。镂空是最典型的用法——树叶、铁丝网、草的轮廓画在贴图的 alpha 通道里,alpha 低于阈值就丢掉。它比半透明混合便宜,因为混合要排序、要读写颜色附件,丢弃只是不写。
2. 帧缓冲
片元着色器的输出是一组数据,这组数据会在经过 ROP 的测试与混合之后写进对应的 附件 里。帧缓冲本身就是所有附件的集合:每个附件各自是一块按像素组织的存储,帧缓冲是这些附件放在一起的逻辑概念——它本身不存数据,只是一个挂载点;管线按挂载点去读或写,像素值全在附件里。
帧缓冲的附件可以分为 颜色附件 、深度附件、模板附件三类:
- 颜色附件(color attachment)可以有多个(具体数量上限由 渲染API 决定,通常是 8 个),可以人为控制每个附件的数据格式(RGBA8、RGBA16F、RGBA32F 等),存储的是最终写进该位置的颜色值(开了多重采样时,一个像素里的每个样本各存一份);
- 深度模板附件(depth-stencil attachment):通常会把深度和模板打包在同一块存储里,数量上最多为 1 个(当不需要进行深度和模板测试时,可以不挂载),常见格式为:
- D24S8:24 位深度 + 8 位模板
- D32F:32 位浮点深度(需要进行深度测试而不需要进行模板测试时,只有深度信息,无模板信息)
- 单独只挂模板、不挂深度的情况很少见:硬件通常把两者打包在同一个格式里,单开一张纯模板图并不省事
通常会把一个附件里面的内容称为一张图像(image),它自带图像格式、尺寸与样本数(sample count)三个属性。图像的元素是像素(pixel):在二维网格上按行列排布、共
width × height个,存放最终写进去的颜色、深度或模板值。默认一个像素就是一份数据;开启多重采样(MSAA)后,一个像素内部还会切成 个样本(sample,即子采样点)。当前阶段我们不去过多考虑多重采样有关的内容,默认一个像素只含一个样本。值得注意的是,这里的像素不能与显示器上的像素对等:可以认为帧缓冲本身就是一个屏幕,我们前面的操作是为了将场景渲染到帧缓冲上(例如 屏幕映射 里的屏幕指的就是帧缓冲,而非显示器)。事实上,一般 渲染API 中会提供默认帧缓冲,往往它就是与显示器直接相连的帧缓冲,渲染到它上面的内容会直接显示在屏幕上;同样地,我们也可以自己创建帧缓冲,并在其上进行渲染,这个操作被称为离屏渲染(off-screen rendering)。离屏渲染本身并不会显示在屏幕上,但是可以被后续的操作使用。
2.1 附件的存储方式
抛开具体的语义和数据解释不谈,每个附件本身就只是一串连续的字节。我们通常将这些字节解释为这样的一个二维数组:image[PixelIndex][ChannelIndex]:
PixelIdex的大小是width × height,表明这个帧缓冲有width × height个像素Channel是每个样本的通道数,通常是 4 (RGBA);现代 GPU 即使使用 RGB 三通道渲染时,也往往会保留(置空)第四个通道作为填充
注:这只是一个逻辑模型,在真实显存里 GPU 会按自己的分块与压缩方式排布,甚至把样本分面存储,不能指望样本在物理地址上紧挨着。
帧缓冲的一致性要求:所有附件的
width、height与样本数必须一致
像素格式决定每个样本占几字节、数值怎么解释。以下是常见的几种格式:
| 格式 | 每样本字节 | 说明 |
|---|---|---|
| RGBA8 | 4 | 每通道 8 位归一化定点,最常见 |
| RGB10A2 | 4 | 颜色各 10 位、alpha 2 位,比 RGBA8 细腻 |
| R16G16B16A16F | 8 | 每通道半精度浮点,能存超过 1 的亮度 |
| D24S8 | 4 | 24 位深度 + 8 位模板打包在一起 |
2.2 容量与带宽
在经过 ROP 的处理后,我们不再考虑 片元 的概念,而是考虑帧缓冲里的像素。我们可以通过访问所有附件的同一个位置,来获取这个像素的所有信息。因此,假定分辨率是 ,每个像素有 个字节,我们读写这个帧缓冲的容量就是
乘上帧率,就是每秒要写进显存的最低数据量:
| 分辨率 | 颜色(RGBA8) | 深度(D24S8) | 一帧合计 | 60 fps 单次全屏写入 |
|---|---|---|---|---|
| 8.3 MB | 8.3 MB | 16.6 MB | 1.0 GB/s | |
| 33.2 MB | 33.2 MB | 66.4 MB | 4.0 GB/s | |
| ,4x MSAA | 33.2 MB | 33.2 MB | 66.4 MB | 4.0 GB/s |
这还是每个样本只被写一次的理想情况。场景里三角形层层叠叠,同一个像素(连同它里面的样本)被反复覆盖的情况叫过度绘制(overdraw),室外场景轻松就有 2~4 层。4 层过度绘制下,1080p 光是颜色写入就要 2 GB/s 左右,再加上深度读写、混合、纹理采样,带宽很快就见底。
注:分辨率的代价是平方级的,而人眼能分辨的细节有上限。抗锯齿、超分、动态分辨率这些技术,本质上都在挪动"像素数"这个性价比拐点。
2.3 将帧缓冲的内容显示在屏幕上
显示器的显像过程是逐行扫描:一行一行地把内存里的像素值取出来点亮,一秒钟重复几十到上百次。但是,这样会引发出来一个问题:假设显示器正在逐行阅读一个帧缓冲里的数据,如果当显示器扫描到某一行的时候,GPU 往这个帧缓冲里面写了新的数据(下一帧的画面),那么真正显示出来的画面就会出现"上半屏是新画面、下半屏还是旧画面"的情况,这种现象叫做撕裂(tearing)。
我们通常会采用双缓冲(double buffering)加垂直同步(vsync)的机制来避免出现画面撕裂的问题。
双缓冲机制
实际上,渲染API 中的默认帧缓冲是由两个帧缓冲组成的,我们会将屏幕正在读取的帧缓冲称为前台缓冲(front buffer),而 GPU 正在渲染的帧缓冲称为后台缓冲(back buffer)。这样只需要将后台缓冲和前台缓冲进行交换(当然这里一般会采取引用交换,而非拷贝),就可以将先前的后台缓冲的内容显示在屏幕上,而 GPU 可以继续在新的后台缓冲上进行渲染。
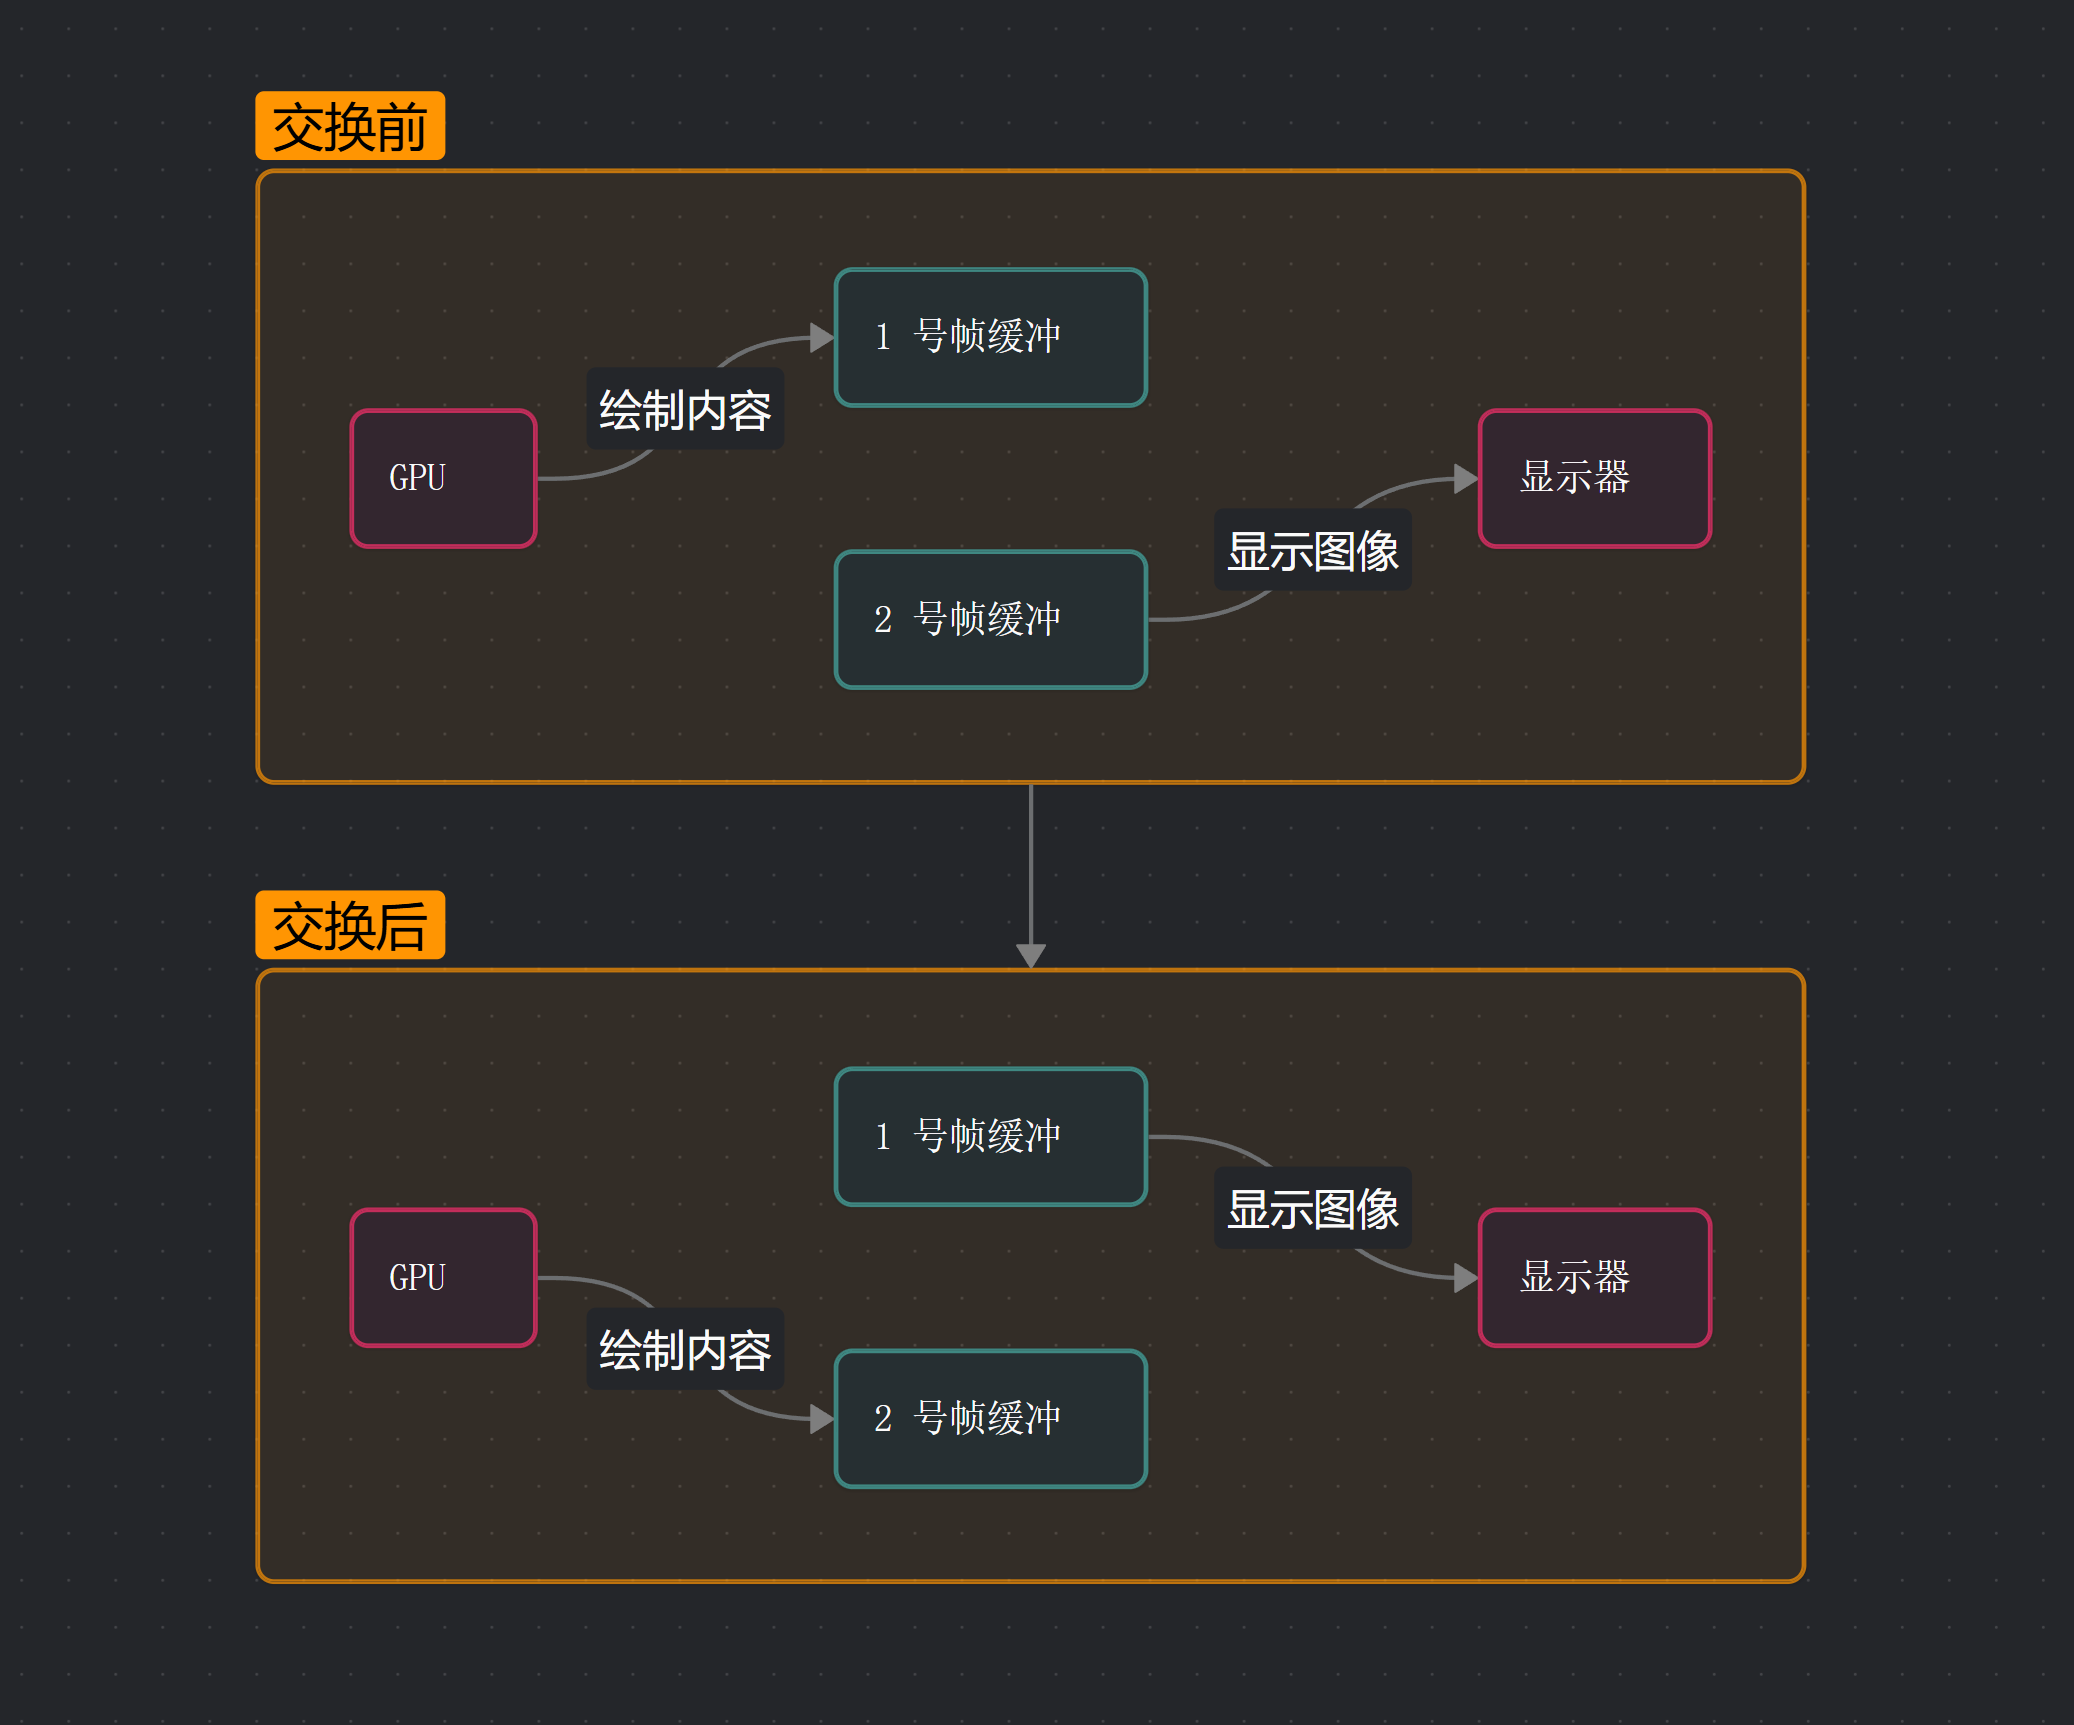
注:交换之后,新的后台缓冲里装的还是上一帧的内容(它刚从前面换下来),所以每帧开头通常要清屏,或者确保整个屏幕都会被覆盖到。
垂直同步
但是,仅靠双缓冲机制是不够的:实际情况下,GPU 渲染一帧的时间与显示器扫描一帧的时间并不一定相等;如果我们在 GPU 渲染完一帧之后立即进行交换,此时若屏幕没有完整扫描完当前帧,GPU 就会将新的后台缓冲的内容显示在屏幕上,这样仍旧会出现画面撕裂的现象。为了解决这个问题,我们需要使用垂直同步(V-Sync)机制。
垂直同步的做法很直接:不允许随意交换缓冲区,只允许在两次扫描之间的垂直消隐期(vertical blanking interval,扫描位置从最后一行的末尾回到左上角、准备下一帧的那一小段时间,也叫垂直回扫期)交换前后缓冲。这样,任何一帧都不会在扫描途中被换掉,撕裂随之消失。
然而,我们的显示器往往会维持一个固定的刷新率,因此交换的时机在每隔固定的间隔出现一次。这样,GPU 的进度就必须去迁就它。按两者谁快谁慢,可以分出两种情况:
- GPU 渲染一帧的时间比显示器扫描一帧的时间长:消隐期到了,GPU 还没渲染完下一帧,没有新画面可换,屏幕只能把当前帧再扫一遍。等 GPU 完成后,还要等到下一个消隐期才能交换,这段内容比预期晚了一个周期才出现,表现为掉帧(frame drop)与卡顿;
- GPU 渲染一帧的时间比显示器扫描一帧的时间短:一帧早就画好了,却必须等消隐期才能交换。后台缓冲被这帧占着,GPU 没有地方画下一帧,只能一起等。帧率被锁死在刷新率上(60 Hz 的屏幕最多 60 fps),帧从渲染完成到真正显示之间还多出一段等待,输入延迟最多增加一个刷新周期。
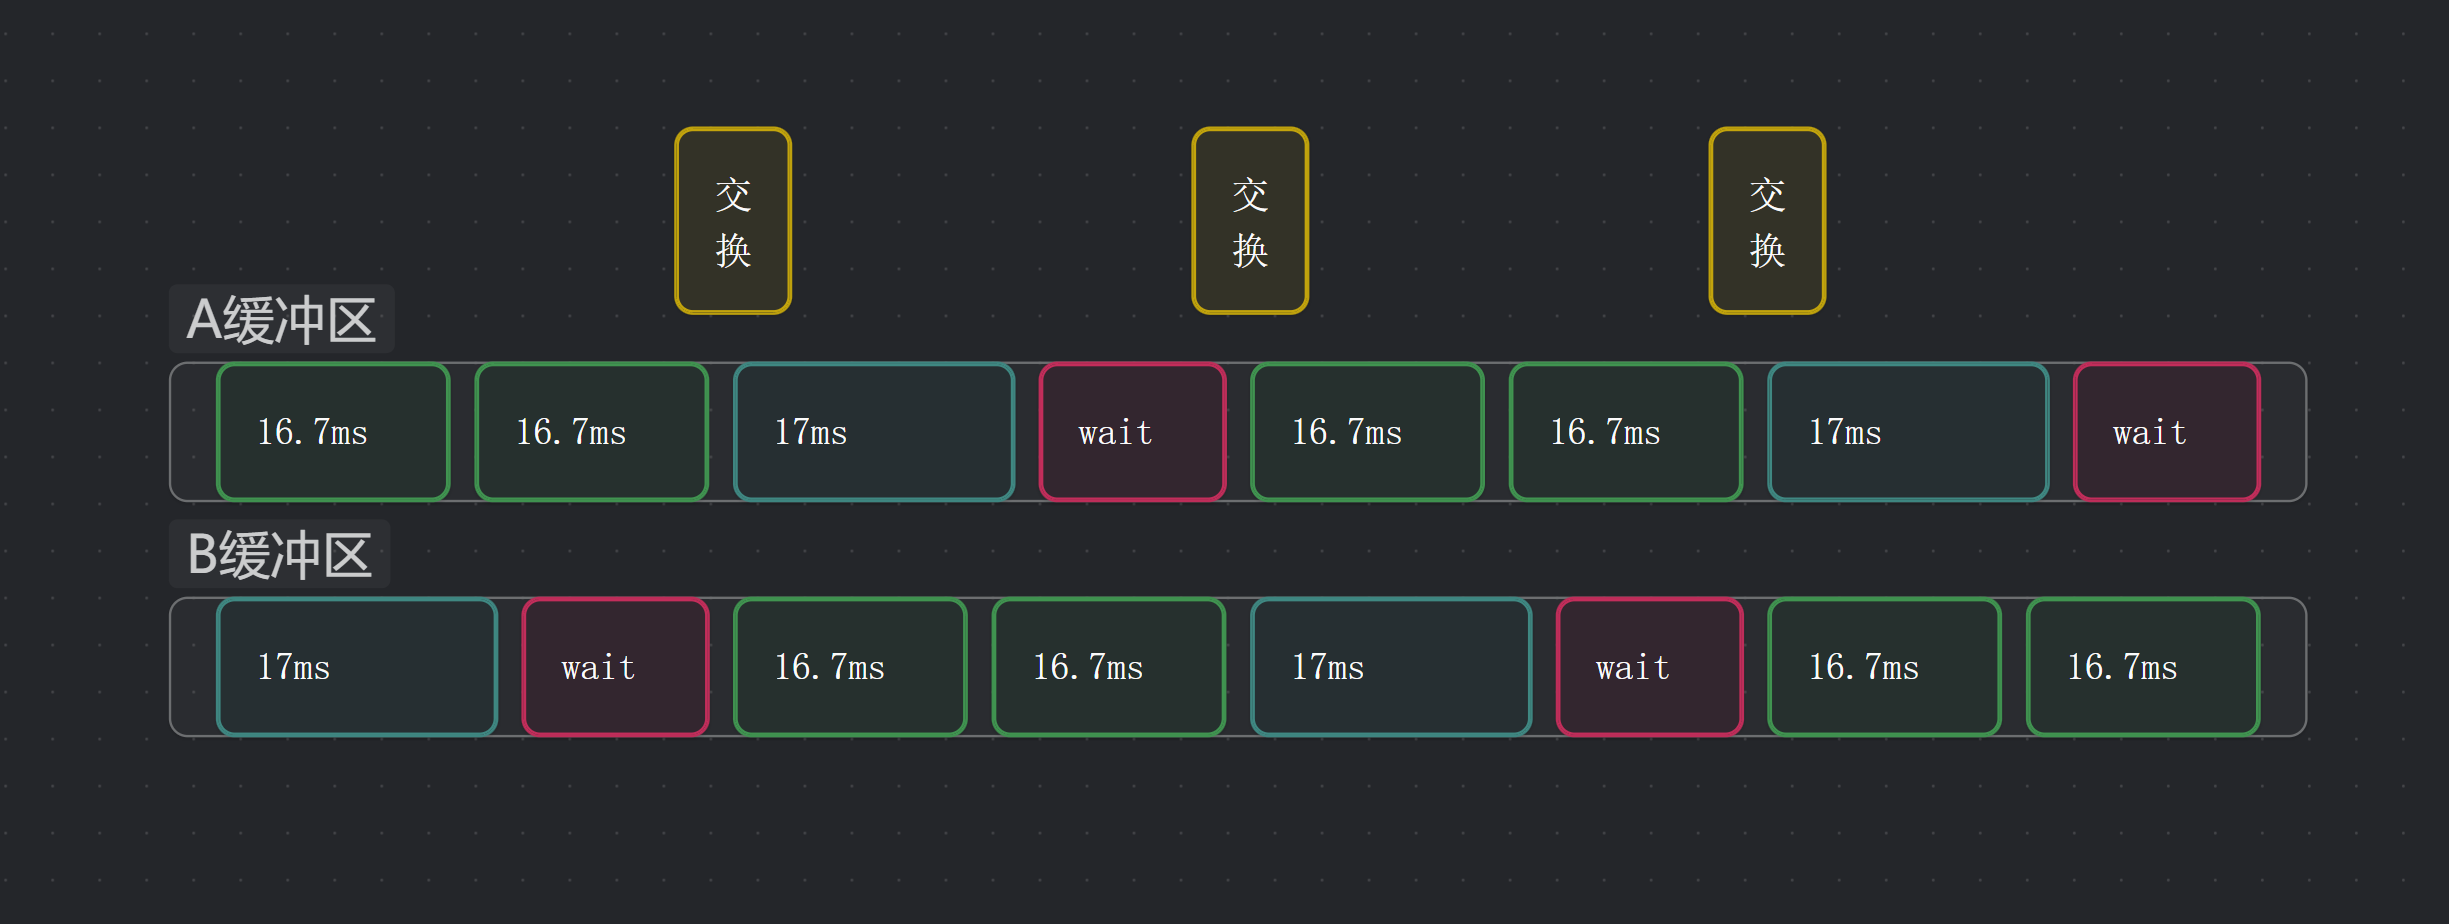
最难受的是两者接近的时候。假设刷新周期是 16.7 ms,GPU 每帧要 17 ms,二者只相差一点点:
- B 在 17 ms 时完成,已经错过了 16.7 ms 的那次消隐期,只能等下一次
- 在等待的这段时间里,前台缓冲 A 正在被扫描,后台缓冲又被 B 占着,两块都不空闲,GPU 连下一帧都没地方画,只能干等
- 到 33.4 ms 交换后 B 上台,GPU 才开始画 C,C 同样晚 0.3 ms,于是又等一个周期。
- 每帧都占掉两个刷新周期,帧率从 60 直接掉到 30,而不是 59
三缓冲
双缓冲卡住的根源是"GPU 想画下一帧时没有空缓冲"。三缓冲(triple buffering)再加一块中间缓冲(middle buffer):一块前台、一块后台正在渲染、一块已经画好等着上台。GPU 画完一帧就把它放进中间缓冲,转去另一块画下一帧,不再等屏幕;到了消隐期,如果中间缓冲里有画好的帧,就换到前台。
GPU 比刷新率快时,三块缓冲是这样轮转的:
| 消隐期 | 前台 | 中间(已画好) | 后台(绘制中) | 交换结果 |
|---|---|---|---|---|
| 1 | A | B | C | B 上台 |
| 2 | B | C | D | C 上台 |
| 3 | C | D | E | D 上台 |
这样 GPU 就不再被屏幕的节奏卡住:每帧只花 17 ms 也好,10 ms 也好,它都能一直画下去,上面那张图里成片的空等消失了,帧率也不会因为"晚 0.3 ms"被砍成一半。中间缓冲里如果已经有一帧还没显示、新的帧又画好了,就用新的覆盖旧的——被丢掉的是过时的帧,看到的总归是最新完成的那一帧。
代价是多一块缓冲的显存,以及延迟。具体多多少取决于排队策略:如果只是让画好的帧排队,队列里堆上两帧,渲染完成到显示之间的延迟会比双缓冲更大;如果只保留最新一帧,延迟就和双缓冲差不多。另外,掉帧本身还在,只是不再被放大:GPU 慢于刷新率时,消隐期到来偶尔没有新帧可换,屏幕把当前帧再扫一遍,抖一下,然后继续。
注:在 渲染API 中,这些策略对应交换链的呈现模式(present mode)。以 Vulkan 为例,
VK_PRESENT_MODE_FIFO_KHR是垂直同步加排队,队列满了提交方就被阻塞;VK_PRESENT_MODE_MAILBOX_KHR是垂直同步加只保留最新一帧,也就是上面说的三缓冲;VK_PRESENT_MODE_IMMEDIATE_KHR完全不等待消隐期,撕裂照旧。DXGI 没有同名的枚举,只能用缓冲数量与Present的同步间隔近似:3 块缓冲配间隔 1 接近 FIFO,间隔 0 则是不等待消隐期。
可变刷新率
垂直同步的种种折中,根源都在于显示器的刷新节奏是固定的,GPU 只能去迁就它。可变刷新率(variable refresh rate,VRR)把方向反过来:显示器不再按固定节拍扫描,收到一帧就刷新一次,帧间隔在支持范围内浮动。GPU 交得快,屏幕就刷新得快;交得慢,屏幕就跟着等。撕裂与等待同时消失,帧率在一个区间里怎么波动都能平滑显示。NVIDIA 的 G-Sync 与 AMD 的 FreeSync 都属于这一类。
实际使用中通常会把帧率上限压在最高刷新率之下一点(比如 144 Hz 的屏幕锁 141 fps),留出余量。帧率顶到上限之后,显示器又回到固定节奏,垂直同步的等待和延迟会重新出现。反过来,帧率掉到刷新范围下限以下时,显示器只能把同一帧重复扫描,效果和掉帧接近。
注:还有一类自适应垂直同步(adaptive V-Sync):帧按时完成就在消隐期交换,一旦发现来不及就立即交换、不做等待。它只在掉帧的那几帧里出现撕裂,其余时候和普通垂直同步一样,属于不增加缓冲的折中方案。
3. 逐片元操作
片元着色器的输出交给流水线的最后一站。这一站不是可编程的,而是一串固定顺序的测试与合并:
片元(位置 + 深度 + 覆盖掩码 + 输出值)
   ↓
裁剪测试(scissor)        超出裁剪矩形的片元丢弃
   ↓
模板测试(stencil)        与模板附件比较,不通过则按规则处理
   ↓
深度测试(depth)          与深度附件比较,更远则丢弃
   ↓
混合(blending)           与颜色附件里已有的值做乘加
   ↓
写掩码(color write mask)  按通道决定哪些位允许被改写
   ↓
颜色附件 / 深度附件 / 模板附件
顺序由硬件固定,改不了,只能开关和设参数。下面按这个顺序逐个看。
3.1 裁剪测试
裁剪测试(scissor test)最简单:应用侧给一个矩形,落在矩形外的片元直接丢弃。它和光栅化之前的图元裁剪不是一回事——图元裁剪裁的是几何,省下的是后续所有阶段的开销;裁剪测试发生在着色之后,着色已经跑完了,省下的只有写入。它的典型用途是把渲染限制在窗口的某一块(分屏、小地图、UI 区域),不必为不同区域切换帧缓冲。
3.2 模板测试
模板附件是每个样本 8 位整数(不开多重采样时即每像素 8 位),默认 0。它像一张印章纸:先往上面盖一个形状,之后再画的片元只有落在"盖章区"里才允许通过。
测试本身很简单,用参考值 ref、掩码 mask 与附件里的值比较:
(ref & mask) 比较函数 (stencil[x][y] & mask)比较函数有"总是通过、从不超过、相等、不等"等一批选项。真正灵活的是失败时的动作:模板失败、深度失败、全部通过这三种情况各可以指定一个操作(保持、清零、替换为参考值、加一、减一、取反等)。于是可以做到"只在没盖过章的地方画一次"——把通过时的操作设为"替换为 1",第二次绘制就会被挡掉。
几个经典用法:
- 遮罩:先画一个圆形把模板写 1,再画一个矩形,只让它出现在圆内;
- 描边:画物体时往模板写 1,然后把物体放大一圈再画一遍,只保留模板值不等于 1 的像素,得到外扩的轮廓;
- 阴影体积(stencil shadow volume):从光源的角度找出模型的轮廓边,沿光线方向挤出成立体,画正面时模板加一、画背面时减一,最后模板不为 0 的像素就在阴影里。它不依赖阴影贴图,代价是几何量巨大,轮廓边缘还会有深度冲突。
3.3 深度测试
深度测试(depth test)用片元的深度与深度附件里的值比较,决定这个片元能不能写颜色。要把它讲清楚,得先知道深度附件里的值是怎么来的。
深度值的来源
顶点着色器输出的是裁剪空间坐标,透视除法之后得到 NDC坐标 里的 ,视口变换再把它线性映射到深度范围,一般就是 ,然后写进深度附件。所以深度附件里存的不是"到相机的距离",而是一个被非线性压缩过的归一化值。
压缩有多狠可以算出来。以近平面 、远平面 、视图空间深度 (朝前为负)为例,透视投影给出
时 , 时 ,两端对得上。它随 的变化率是
分母上有 :离相机越近,深度值变化得越快,占用的存储区间越多;越远越挤在一起。取 、,距离相机 1 米处 ,映射到 是 ——头 1 米用掉了 90% 的深度范围,剩下 999 米挤在最后 10% 里。
深度比较与更新
有了深度附件,遮挡关系就不需要排序了。以“更近者胜”为例:
// 伪代码:深度测试
if (fragment.depth < depthAttachment[x][y])
{
    depthAttachment[x][y] = fragment.depth;   // 记住这里最近是这个
    accept(fragment);                          // 这个片元才有资格写颜色
}
else
{
    reject(fragment);                          // 被更近的东西挡住,直接扔
}
不管三角形以什么顺序绘制,每个像素最后留下的都是深度最小的那个片元,因为附件里始终记着"目前为止最近的值"。相比之下,画家算法要从远到近画,还得处理互相遮挡的循环,深度附件用一块内存就换掉了排序。
深度精度
代价是精度。深度附件的位宽决定能分辨多少级:16 位只有 65536 级,24 位有 1677 万级。两个表面离得太近、压缩后落进同一个量化台阶,深度比较的结果就会随视角与舍入抖动,画面出现交替闪烁的花纹,这就是 z-fighting。缓解手段有三类:
- 把近平面推远一点,或者减小远近平面的比值,让压缩别那么极端;
- 提高深度附件位宽(24 位是最常用的折中);
- 反转深度(reverse-z):把近处映射到 1、远处映射到 0,并改用浮点格式。浮点数的有效位集中在 0 附近,反转之后正好把精度让给挤在一起的远处。
提前深度测试
被遮挡的片元算出来也白算,所以 GPU 想把深度测试提到着色之前,先筛后算,这叫 early-z。前提是着色器不能改变结论:只要它可能改写深度、或者会丢弃片元,硬件就无法预判,只能等着色之后再做深度测试(late-z)。
注:这也是丢弃片元要省着用的原因,尤其在大片被遮挡的物体上——它不但让自己的片元失去 early-z,还会让整批绘制都没法提前测试。
顺着同一个想法,不少渲染器会先跑一遍深度预通道(depth prepass):用几乎为空的片元着色器把所有可见表面的深度写进深度附件,再正常渲染。第二遍时被挡住的片元在着色前就被剔除,着色次数从"覆盖层数"降到"可见层数"。它值不值得取决于过度绘制有多严重、深度与颜色的带宽谁更贵——对几何简单、遮挡很少的场景,预通道反而纯亏一遍带宽。
3.4 混合
混合(blending)发生在深度测试通过之后,把片元的值与颜色附件里已有的值合成:
其中 是新片元的颜色, 是附件里的旧颜色, 是由状态指定的系数。最常见的组合是 、:
这里有一个必须注意的性质:混合不满足交换律。先画红再叠半透明的蓝,与反过来画,结果完全不同。所以半透明物体必须按深度从远到近排序后绘制;也正因为要排序,半透明物体通常还要关掉深度写入,否则它会把后面的东西整片挡掉。
两个补充:
- 加法混合()是可交换的,光晕、粒子、火焰这类纯发光效果用它,不需要排序;
- 预乘 alpha(premultiplied alpha)把 提前乘进颜色,存的是 ,插值与混合都能直接在分量上做线性运算,纹理边缘不会出现"黑边"。
3.5 多重采样
不开多重采样时,每个像素只有一个样本,覆盖与否只有 0 和 1 两种结果,做不到"覆盖 70%"这种中间值,边缘因此是硬邦邦的阶梯。多重采样(MSAA)让一个像素带 个样本:每个样本在像素内各有自己的位置,各自参与覆盖判定与深度测试。
| 每个像素 | 存几份 | 说明 |
|---|---|---|
| 覆盖掩码 | 1( 位) | 哪些样本落在三角形内 |
| 深度 | 每个样本各自做深度测试 | |
| 颜色 | 着色结果写到被覆盖的样本上 |
渲染结束时做一次解析(resolve):把 个样本的值平均成一个像素颜色,写进普通的单采样缓冲,之后才能显示或当纹理用。
MSAA 的聪明之处在于着色仍按像素执行一次:边缘像素里有几个样本被覆盖,只决定"这次着色覆盖多大比例",不额外跑着色器。于是只有覆盖与深度按 倍开销,最贵的着色没有变多。代价是显存,4x MSAA 的颜色与深度附件都是 4 倍大,所以上表中 1080p 配 4x MSAA 的占用与 4K 单采样正好相等。
注:片元着色器在 MSAA 下仍然每个片元跑一次,只是这个片元代表一个像素而不是一个样本。若确实需要逐样本着色(像素级细节很密时),可以强制打开逐样本着色,代价自然也是着色次数乘上 。

