
静态库与动态库的基础知识
需要预先学习:
1. 库
假设有一些许多项目都要用到的函数,比如在某一个项目里面写了个 calculate.cpp。此时如果另一个项目也想用这几个函数,最直接的做法是把源码复制过去。但是这种做法会导致以下几个问题:
- 如果有很多项目都想用到这份代码,需要多次重复复制一样的源码
- 如果发现其中有一个 bug,进行修复时需要在每个项目里都改一遍
- 每个项目都要单独编译这份代码,会造成编译时间延长,也会导致生成的二进制文件体积膨胀
- 有可能会出现不同项目中的 ``calculate.cpp` 版本不一致,导致行为不一致
库(library)就是为解决这类问题出现的。它是一批已经编译好的目标代码,连同符号表、重定位信息、初始化信息等元数据打包在一起。库可以被链接器合并进可执行文件,也可以在程序运行时被加载器映射进进程的地址空间。
从使用者的角度看,库提供了两样东西:
- 一组可以调用的符号(函数名、变量名),以及它们对应的机器码和数据
- 一份 ABI(Application Binary Interface,应用二进制接口)——调用方按什么规则传参、返回值放在哪、对象的大小、名字修饰的细节
1.1 从源文件到库文件
编译的四个阶段
一个 .cpp 文件变成库,中间要经过一串工具。以 GCC 对 add.cpp 进行操作为例:
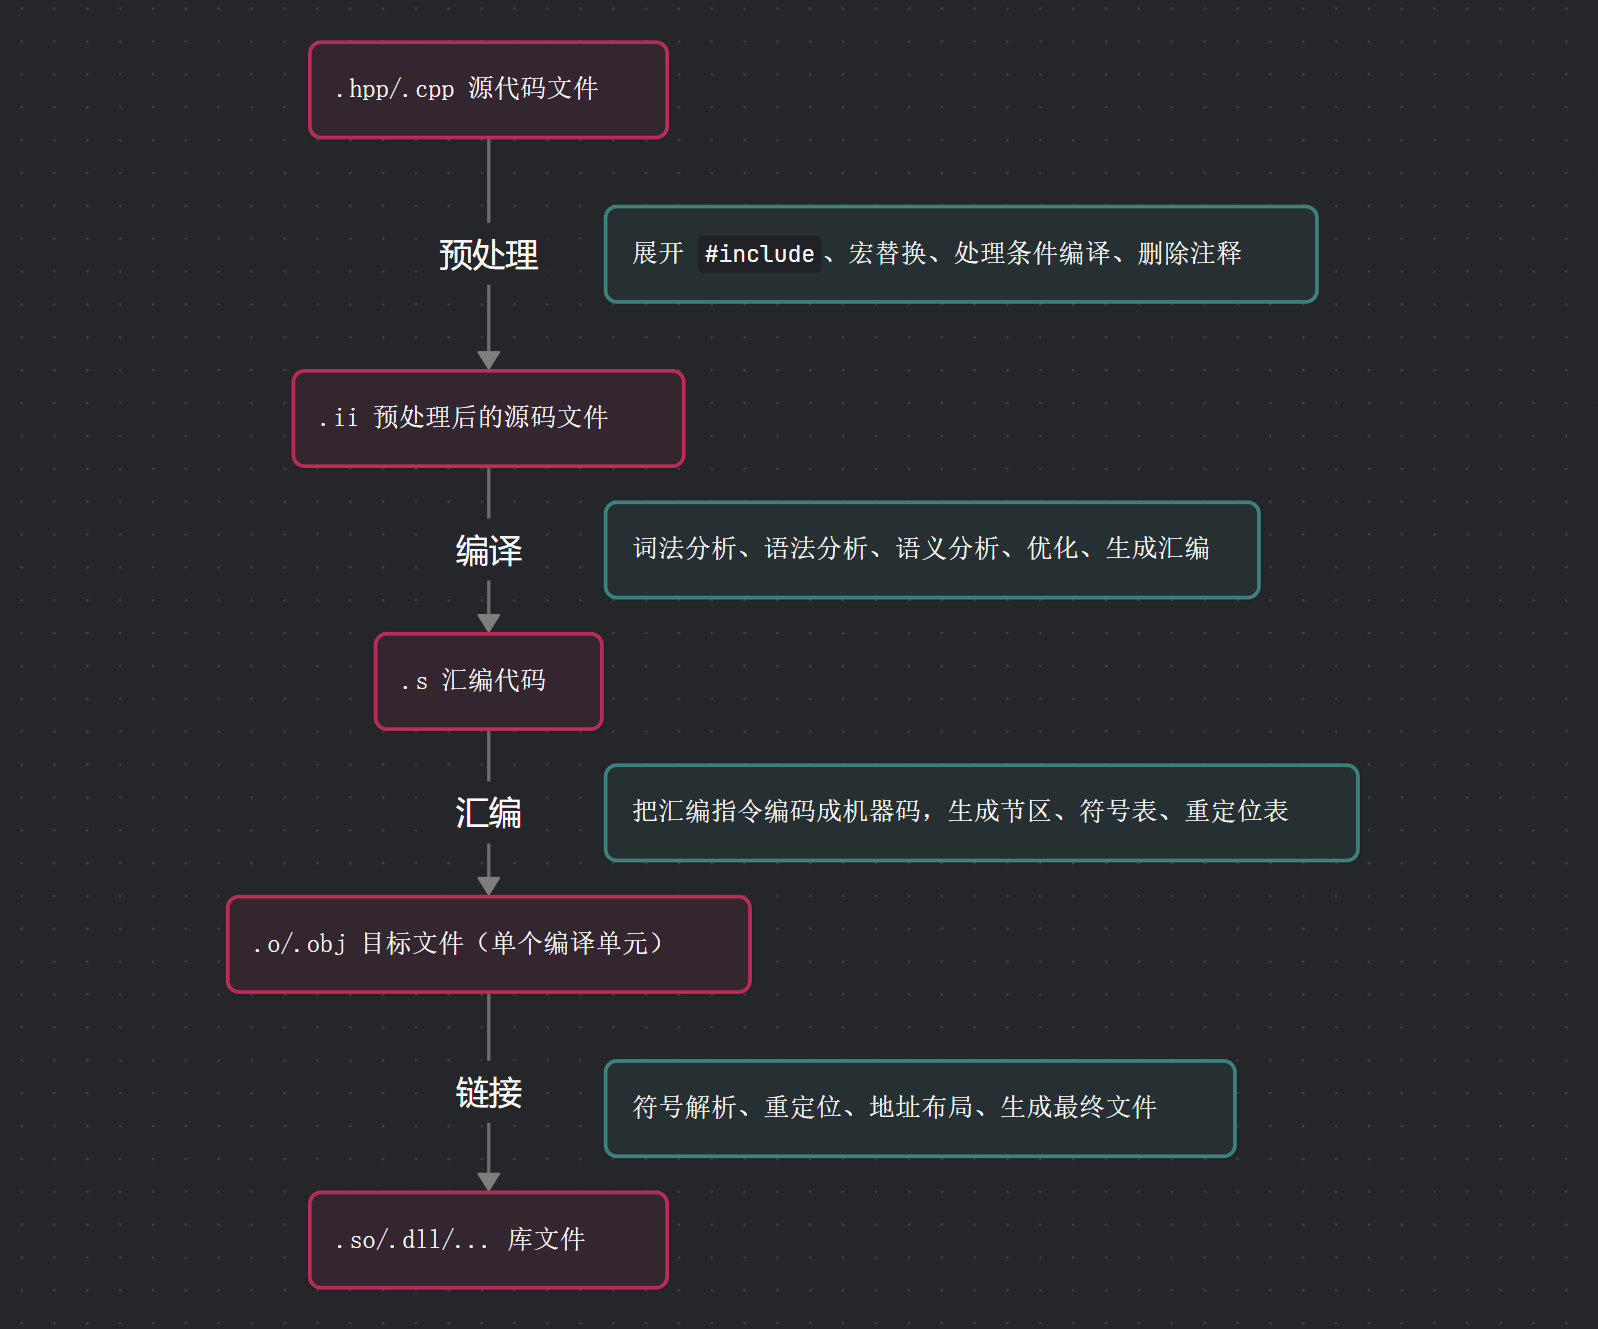
对应的 GCC 命令是:
g++ -E add.cpp -o add.ii      # 只做预处理
g++ -S add.ii -o add.s        # 只做到汇编
g++ -c add.s -o add.o         # 只做到目标文件
g++ add.o main.o -o app       # 链接
日常更常用的是把前两步合并:
g++ -c add.cpp -o add.o # 预处理 + 编译 + 汇编初步认识静态库与动态库
一个库的生成路径,取决于它是静态库还是动态库:
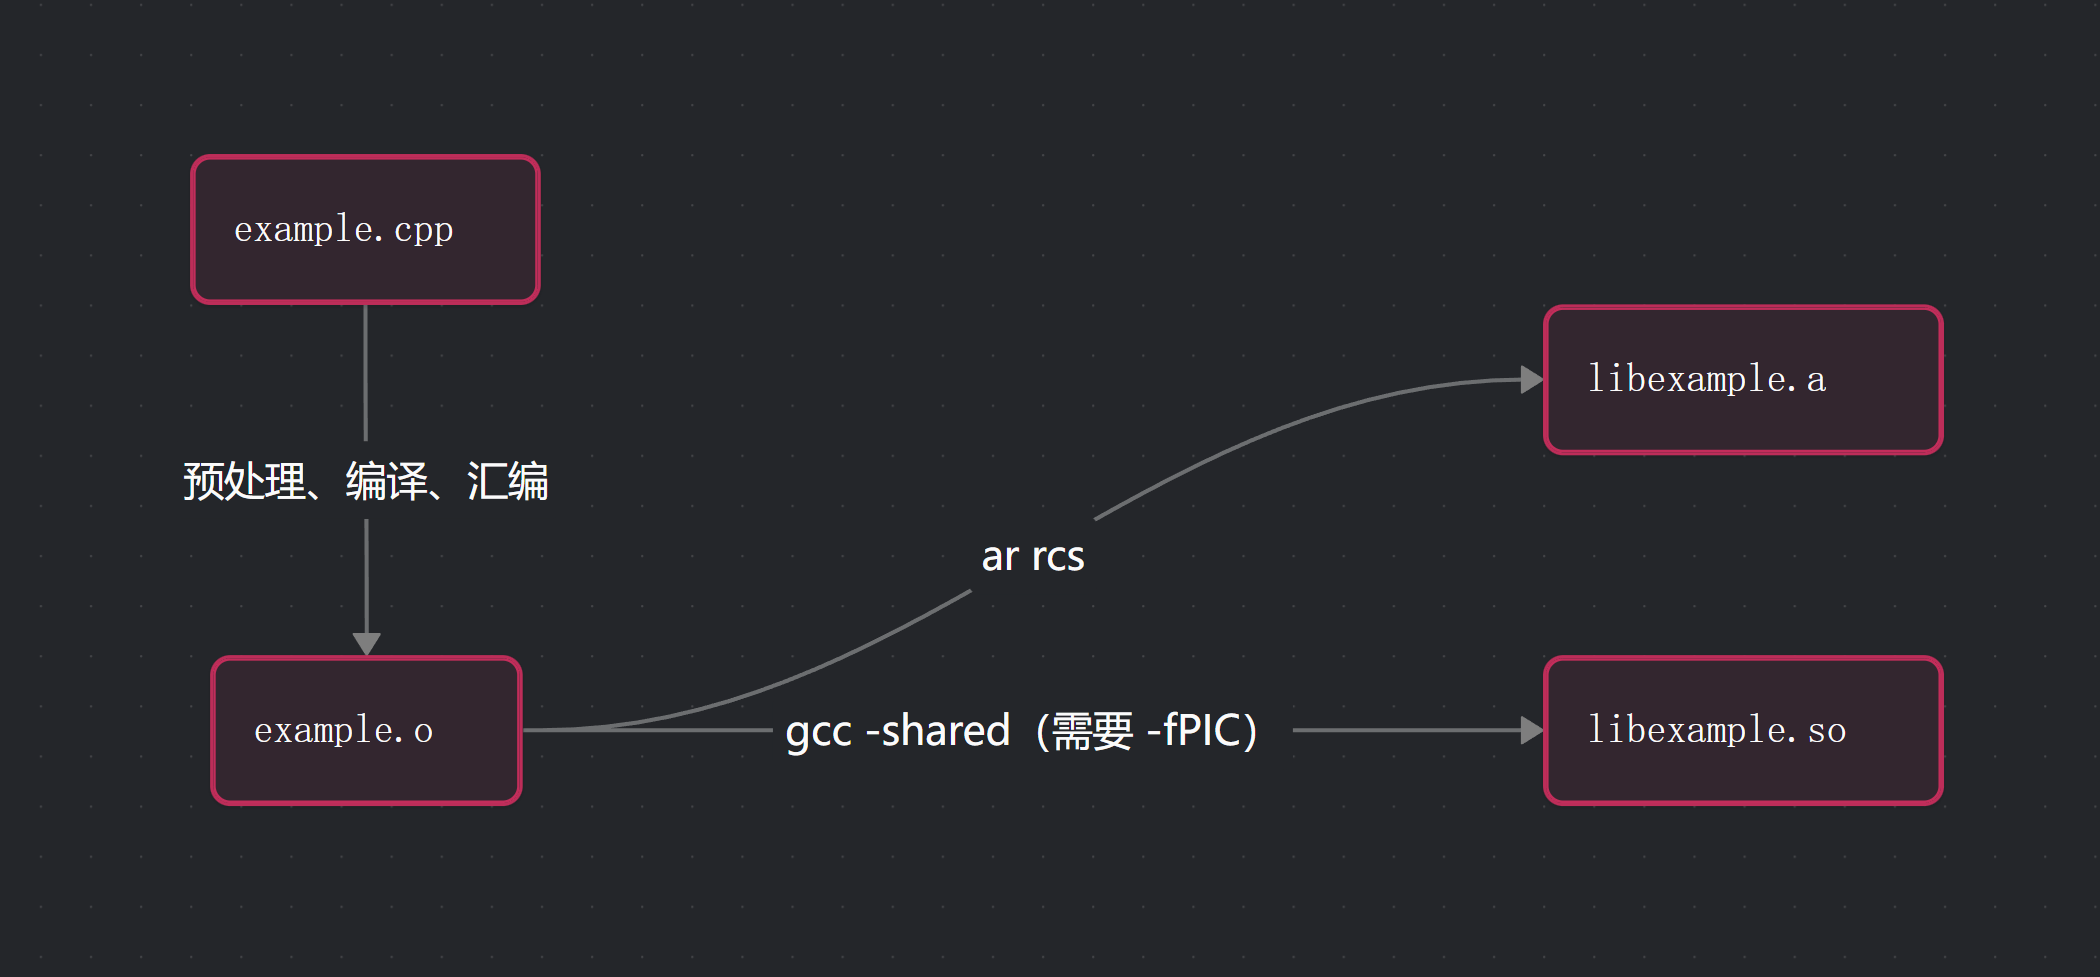
ar是 binutils 里的归档工具,用来打包一堆.o生成 Linux 静态库.a;ar rcs是写 Makefile 最标准的一条创建静态库命令,其中- r(replace):插入目标文件;库里已有同名
.o就覆盖,没有就追加进去 - c(create):如果这个
.a文件本来不存在,就新建它;不加 c 的话,新建时 ar 会打印警告 - s(symbol index):给静态库生成符号索引表,等价于单独跑一遍
ranlib libfoo.a。没有这个索引,链接器可能找不到符号、链接失败
- r(replace):插入目标文件;库里已有同名
g++ -shared是 GCC 的动态库生成选项,Linux 下生成 动态库.so;-fPIC即 Position-Independent Code,位置无关代码,确保生成的机器码里,没有硬编码的绝对内存地址,运行时可以被加载到虚拟地址空间的任意位置。详细的细节会在下文提及。
这个分叉是理解两种库的第一把钥匙:
- 静态库不是链接产物,它只是把
.o文件按某种格式装进一个文件,里面的符号仍然是"未解析"的状态。真正把符号对上、把地址填好的工作,发生在链接可执行文件的时候。 - 动态库是链接产物,它自己就经过了链接:内部的符号已经解析、地址已经按"加载基址为 0"排好、重定位表和动态符号表已经生成。它同时又是下一次链接(链接可执行文件)的输入。
目标文件里有什么
在 Linux 上,.o 是 ELF 可重定位文件(relocatable file)。用 readelf -S add.o 可以看到它的节区表,典型内容如下:
There are 13 section headers, starting at offset 0x2c0:

Section Headers:
  [Nr] Name              Type             Address           Offset
       Size              EntSize          Flags  Link  Info  Align
  [ 0]                   NULL             0000000000000000  00000000
  [ 1] .text             PROGBITS         0000000000000000  00000040
  [ 2] .data             PROGBITS         0000000000000000  00000050
  [ 3] .bss              NOBITS           0000000000000000  00000058
  [ 4] .comment          PROGBITS         0000000000000000  00000058
  [ 5] .note.GNU-stack   PROGBITS         0000000000000000  00000078
  [ 6] .note.gnu.property PROGBITS        0000000000000000  00000080
  [ 7] .eh_frame         PROGBITS         0000000000000000  000000a0
  [ 8] .rela.eh_frame    RELA             0000000000000000  00000118
  [ 9] .symtab           SYMTAB           0000000000000000  00000138
  [10] .strtab           STRTAB           0000000000000000  000001a0
[11] .shstrtab STRTAB 0000000000000000 000001e0每个节区承担不同的职责,下面这个表格的内容可供略览:
| 节区 | 类型 | 内容 | 是否占文件空间 | 加载后权限 |
|---|---|---|---|---|
.text |
PROGBITS | 机器指令 | 是 | 读 + 执行 |
.rodata |
PROGBITS | 只读数据:字符串字面量、常量表、虚函数表 | 是 | 读 |
.data |
PROGBITS | 已初始化的可写全局/静态变量 | 是 | 读 + 写 |
.bss |
NOBITS | 未初始化(或初始化为 0)的全局/静态变量 | 否 | 读 + 写 |
.tdata / .tbss |
PROGBITS / NOBITS | 线程局部存储的初始化/未初始化部分 | 视情况 | 读 + 写 |
.init_array |
PROGBITS | 全局构造函数指针数组 | 是 | 读 + 写(加载后可能只读) |
.fini_array |
PROGBITS | 全局析构函数指针数组 | 是 | 读 + 写(加载后可能只读) |
.eh_frame |
PROGBITS | 异常展开信息(栈帧描述) | 是 | 读 |
.gcc_except_table |
PROGBITS | 异常处理表(catch 的匹配信息) | 是 | 读 |
.symtab |
SYMTAB | 符号表 | 是 | 不加载 |
.strtab |
STRTAB | 符号名字符串 | 是 | 不加载 |
.rela.text 等 |
RELA | 重定位表 | 是 | 不加载 |
.note.GNU-stack |
PROGBITS | 标记栈不可执行 | 是 | 不加载 |
.note.gnu.property |
PROGBITS | 硬件特性标记,如 CET/IBT | 是 | 不加载 |
.comment |
PROGBITS | 编译器版本字符串 | 是 | 不加载 |
.debug_* |
PROGBITS | 调试信息(加 -g 才有) |
是 | 不加载 |
几个值得注意的点:
1. .bss 不占文件空间。 它的大小记录在节区头里,类型是 NOBITS,文件里没有对应的字节。加载器看到它,直接在内存里映射一段匿名零页。一个 char buffer[1024 * 1024 * 1024]; 的全局数组,会让运行中的 .bss 占用变成 1GB,但可执行文件本身不会因此大 1GB。
2. .data 和 .rodata 的分界由"是否可写"决定,而不是由 const 决定得那么绝对。 字符串字面量、const int 通常进 .rodata;但一个带指针的 const 结构体,如果指针需要在加载时重定位,编译器会把它放进 .data.rel.ro——“加载时只读”(relocation read-only),等加载器填完地址后再用 mprotect 改成只读。
3. .eh_frame 往往比代码本身还大。 C++ 的异常是"零开销"模型:不抛异常时没有运行时判断,代价是把栈帧信息记录在 .eh_frame 里,抛异常时再查表展开。一个大量使用异常和模板的库,.eh_frame 可能占文件的一半以上。这是库体积分析时经常被忽略的部分。
4. .symtab 不参与运行。 它只是给链接器和调试器看的。strip 删掉 .symtab 之后,程序照样能跑,动态库照样能被加载——因为运行时需要的是 .dynsym,那是另一张表(后面详细讲)。
符号:链接器眼中的世界
目标文件里最关键的元数据是符号表(symbol table)。每个符号描述一个"名字"和"某块内容"的对应关系:
$ readelf -s add.o

Symbol table '.symtab' contains 5 entries:
   Num:    Value          Size Type    Bind   Vis      Ndx Name
     0: 0000000000000000     0 NOTYPE  LOCAL  DEFAULT  UND
     1: 0000000000000000     0 FILE    LOCAL  DEFAULT  ABS add.cpp
     2: 0000000000000000     0 SECTION LOCAL  DEFAULT    1 .text
     3: 0000000000000000    26 FUNC    GLOBAL DEFAULT    1 add
     4: 0000000000000000     0 NOTYPE  GLOBAL DEFAULT  UND printf
几个字段的含义:
- Value:符号在所属节区里的偏移。在
.o里,节区的起始地址是 0,所以这个值就是"相对于.text开头第几个字节"。 - Size:符号占多少字节。函数就是机器码长度,变量就是类型大小。
- Type:
FUNC(函数)、OBJECT(变量)、SECTION(节区)、FILE(源文件名)、NOTYPE。 - Bind:
LOCAL(只在本文件可见)、GLOBAL(可被其他文件引用)、WEAK(弱符号,允许被强符号覆盖)。 - Vis:可见性,
DEFAULT、HIDDEN、PROTECTED。 - Ndx:符号所在的节区编号。
UND表示"未定义"——这个符号在本文件里只有引用,没有定义;ABS表示绝对值,不归属任何节区。 - Name:符号名。C++ 的符号名经过名称修饰(name mangling),
add(int, int)会变成_Z3addii这样的形式,原因见 extern “C”。
链接器面对的核心问题可以概括成一句话:把每个 UND 的符号,找到唯一一个 GLOBAL 的定义。
nm 命令能直接列出符号,用字母表示符号的类型:
| 字母 | 含义 |
|---|---|
T / t |
.text 中的符号(函数),大写是全局,小写是局部 |
D / d |
.data 中的已初始化变量 |
B / b |
.bss 中的未初始化变量 |
R / r |
.rodata 中的只读数据 |
U |
未定义,需要别的目标文件或库提供 |
W / w |
弱符号(未定义或已定义) |
V / v |
弱对象 |
C |
公共符号(common symbol) |
A |
绝对地址符号 |
$ nm -C add.o
0000000000000000 T add(int, int)
                 U printf
-C 会把修饰后的名字还原成可读形式。没有 -C 时看到的是 _Z3addii。
重定位:地址还没定下来
目标文件里的指令还不能直接执行,因为有一类地址在编译时根本不知道。比如:
// add.cpp
int add(int a, int b)
{
    return a + b;
}

// main.cpp
int add(int, int);

int call_add()
{
    return add(1, 2);
}
main.cpp 编译成 main.o 时,编译器知道"要调用 add",但不知道 add 最终会被放在哪个地址——它可能在同一个 .o 里,可能在另一个 .o 里,可能在静态库里,也可能在动态库里。于是编译器先在指令里填一个占位值,再在 .rela.text 里记一条重定位(relocation):
$ objdump -dr main.o

0000000000000000 <_Z8call_addv>:
   0:   48 83 ec 08          sub    rsp,0x8
   4:   ba 02 00 00 00       mov    edx,0x2
   9:   be 01 00 00 00       mov    esi,0x1
   e:   e8 00 00 00 00       call   13 <_Z8call_addv+0x13>
                        f: R_X86_64_PLT32  _Z3addii-0x4
  13:   48 83 c4 08          add    rsp,0x8
  17:   c3                   ret
call 指令后面那 4 个字节是 0,因为还不知道目标地址。重定位条目告诉链接器:
- Offset = 0xf:要修改的位置是
.text偏移0xf处的 4 个字节 - Type = R_X86_64_PLT32:按"相对于下一条指令的 32 位偏移"来填,必要时通过 PLT 跳转
- Symbol =
_Z3addii:目标符号 - Addend = -0x4:修正值。x86 的相对跳转是"从下一条指令的地址算起",而重定位的基准是"重定位字段本身的地址",两者差 4 个字节,所以要减 4
链接器做完符号解析后,知道 add 的最终地址,就能算出 目标地址 - (下一条指令地址),把结果写回这 4 个字节。这个过程叫重定位(relocation)。
常见的 x86-64 重定位类型:
| 类型 | 用途 | 说明 |
|---|---|---|
R_X86_64_64 |
绝对 64 位地址 | 常见于指针初始化 |
R_X86_64_PC32 |
相对 32 位偏移 | 同模块内的数据访问、函数调用 |
R_X86_64_PLT32 |
通过 PLT 的相对调用 | 调用可能被插入(interpose)的函数 |
R_X86_64_32 / 32S |
绝对 32 位地址 | 非 PIC 代码里的绝对地址;32S 要求符号值非负 |
R_X86_64_GOTPCREL |
相对 GOT 的偏移 | PIC 代码取外部变量/函数地址 |
R_X86_64_GLOB_DAT |
GOT 项 | 动态链接时填数据符号地址 |
R_X86_64_JUMP_SLOT |
GOT 项 | 动态链接时填函数地址,配合 PLT 懒绑定 |
R_X86_64_RELATIVE |
基址相对 | 动态库内部指针,加载时加上基址 |
R_X86_64_COPY |
复制重定位 | 非 PIC 可执行文件引用动态库中的数据 |
R_X86_64_IRELATIVE |
IFUNC 解析 | 间接函数(ifunc)的地址由函数在加载时决定 |
R_X86_64_PC32 只能表示 ±2GB 的范围。如果你的可执行文件或库大到超过这个范围,链接时会看到:
relocation truncated to fit: R_X86_64_PC32 against symbol `foo'这不是"内存不够",而是指令编码里的 32 位偏移放不下。解决办法是改代码模型(-mcmodel=medium / large),或者把庞大的库拆小,或者用 -Wl,--no-relax 之外的布局调整。实际项目里更常见的是把巨型静态库拆成多个动态库,让每个模块的地址范围落回 ±2GB 内。
链接器做的两件事
把上面的内容收拢,链接器(ld、lld、link.exe)主要做两件事:
1. 符号解析(symbol resolution)——为每个未定义符号找到唯一的定义。找不到就报 undefined reference / unresolved external symbol;找到多个强定义就报 multiple definition。
2. 重定位与布局(relocation and layout)——把所有输入节区按规则合并、对齐、分配到输出文件的虚拟地址上,然后遍历重定位表,把每条引用填成最终地址。
除此之外,链接器还会做:
- 合并相同性质的节区(所有
.text合成一个.text,所有.data合成一个.data) - 处理弱符号、COMDAT 组(模板和内联函数的重复定义)
- 处理公共符号(common symbol)
- 丢弃无用节区(
--gc-sections) - 生成程序头(program header),告诉加载器哪些节区要映射、映射到什么权限
- 生成
.eh_frame_hdr、.gnu.hash、.note.gnu.build-id等辅助结构
对一个静态库来说,第 1、2 步都还没发生。静态库只是把 .o 装进一个盒子,盒子里的每个 .o 仍然带着自己的符号表和重定位表。等到链接可执行文件时,链接器才会打开盒子,按需取出成员。
对一个动态库来说,链接器已经做过一轮符号解析和重定位,但只解析"库内部能解析的"符号;对 libc 等外部依赖,它留下 UND,记录在 .dynsym 和 DT_NEEDED 里,等运行时由动态加载器继续解析。
库的本质
现在可以给库下一个更准确的定义:
库 = 一批目标代码 + 符号表 + 重定位信息 + 链接/加载所需的元数据。
静态库和动态库的区别,不在于"里面有没有机器码",而在于元数据的组织方式和谁来消费这些元数据:
| 静态库 | 动态库 | |
|---|---|---|
| 本质 | .o 的归档包 |
已链接的 ELF/PE 映像 |
| 符号表 | .symtab(每个成员各有一份) |
.dynsym(运行时用)+ .symtab(可选) |
| 重定位 | 保留在成员里,链接可执行文件时处理 | 分成链接时已处理的部分和加载时处理的部分 |
| 消费者 | 静态链接器 ld |
动态加载器 ld.so / Windows Loader |
| 地址 | 成员内地址从 0 开始 | 节区地址从 0 开始,加载时加基址 |
| 是否可单独运行 | 否 | 否(但可以被加载) |
1.2 静态库
定义与文件格式
静态库(static library)是把多个目标文件打包成一个文件,供链接器在生成可执行文件时按需取用。
| 平台 | 后缀 | 打包工具 | 格式 |
|---|---|---|---|
| Linux | .a |
ar |
Unix ar 归档 |
| Windows | .lib |
lib.exe |
COFF 归档 |
| macOS | .a |
ar / libtool |
Mach-O 归档 |
| MinGW | .a / .lib |
ar / dlltool |
ar 归档 |
.a 的文件格式是 ar 归档(archive)。它非常简单:一个全局魔数 !<arch>\n,后面跟着一串成员(member),每个成员有一个 60 字节的头部,记录名字、时间戳、属主、权限、大小,然后是该成员的原始字节。GNU ar 还会在开头放一个特殊的符号索引成员(名字是 /),里面记录"哪个符号由哪个成员定义",这样链接器不必扫描整个归档就能找到需要的成员。
!<arch>\n
├── /              符号索引(symbol index)
├── add.o          普通目标文件
├── sub.o
└── util.o
可以直接查看和拆开:
ar t libadd.a          # 列出成员
ar tv libadd.a         # 列出成员及详细信息
ar x libadd.a          # 把成员解压到当前目录
ar rcs libadd.a add.o  # 创建/替换成员并写索引
ranlib libadd.a        # 只重建符号索引(等价于 ar s)
nm -s libadd.a         # 查看归档的符号索引
ar rcs 里的三个字母分别是:
r:replace,如果成员已存在就替换,不存在就插入c:create,归档不存在就创建s:symbol index,写符号索引
注:GNU ar 默认是确定性模式(deterministic mode):时间戳、uid、gid 都写成 0,保证同样的输入产生逐字节相同的归档。这对可复现构建(reproducible build)很重要。老式的
ar会记录真实时间,导致每次打包的哈希都不同。需要恢复旧行为时用ar U。
Windows 的 .lib 有两种完全不同的东西,共用同一个后缀,这是初学者最容易混淆的地方之一:
- 静态库:和 Unix 的
.a一样,是一堆.obj的 COFF 归档,链接时把代码复制进 exe - 导入库(import library):DLL 的"提货单",里面没有实际代码,只有用于填充导入表的存根和
__imp_符号,链接时告诉链接器"这个函数在某个 DLL 里"
判断方法:dumpbin /symbols 看有没有 __imp_ 前缀的符号,或者看文件大小(导入库通常只有几 KB 到几十 KB)。
静态库的链接过程
静态链接的核心规则是:只取出需要的成员,不用的成员不参与链接。
链接器维护两个集合:
- 已定义符号集合:目前已经见过的所有强定义
- 未定义符号集合:目前还缺的引用
处理顺序大致是:
- 从左到右扫描命令行上的输入文件
- 遇到普通
.o,把它整个加入输出,更新两个集合 - 遇到静态库,查库的符号索引,只取出"定义了当前未定义符号"的成员;取出的成员又可能引入新的未定义符号,于是继续在同一个库里查,直到没有新的成员被取出
- 继续处理下一个输入
- 扫描结束后,如果未定义集合非空,报错
这个规则带来一个非常实际的后果:库在命令行上的顺序很重要。
gcc main.o -L. -ladd -o app      # 正确
gcc -L. -ladd main.o -o app      # 可能失败
第二种写法里,链接器先看到 libadd.a。此时 main.o 还没被处理,链接器不知道 main 需要 add,于是 libadd.a 里的 add.o 不会被取出。等处理到 main.o 时,add 成了未定义符号,但库已经扫描过了,GNU ld 不会回头再扫。
报错通常是这样:
main.o: In function `main':
main.cpp:(.text+0x15): undefined reference to `add(int, int)'
collect2: error: ld returned 1 exit status
有三种常见解法:
1. 调整顺序,把库放在使用它的目标文件后面:
gcc main.o -L. -ladd -o app2. 用 --start-group / --end-group 处理循环依赖:
gcc main.o -Wl,--start-group -la -lb -Wl,--end-group -o app链接器会在组内反复扫描,直到没有新的符号被解析。代价是链接变慢,所以只在确实有循环依赖时用。
3. 用 --whole-archive 强制取出所有成员:
gcc main.o -Wl,--whole-archive -ladd -Wl,--no-whole-archive -o app这会绕过"按需取用"的规则,把库里所有 .o 都链进来。常见于两种情况:库里有靠静态构造函数注册的代码(不引用也会被丢弃),或者需要把符号完整导出给 dlopen 的插件使用。
注:MSVC 的
link.exe对库顺序的敏感度通常比 GNU ld 低,很多情况下不需要手动分组;但同名符号的优先级仍受顺序影响,而且不要依赖这个行为——显式写出依赖顺序在任何工具链上都是安全的。
成员粒度与死代码
静态库的取用单位是整个 .o 成员,不是单个函数。假设 util.o 里有 foo()、bar()、baz() 三个函数,main 只调用了 foo(),链接器仍然会把整个 util.o 拉进来,bar() 和 baz() 的机器码也一起进入可执行文件。
如果 bar() 又引用了另一个库里的符号,那个库也会被牵连进来。这就是"静态库越链越大"的一个原因。
解决办法是让编译器和链接器按函数/数据切分节区:
g++ -c -ffunction-sections -fdata-sections util.cpp -o util.o
g++ main.o util.o -Wl,--gc-sections -o app-ffunction-sections:每个函数单独一个节区,比如.text.foo、.text.bar-fdata-sections:每个变量单独一个节区--gc-sections:从入口点出发做可达性分析,丢弃没有被引用的节区
MSVC 的对应选项是 /Gy(函数级链接)加 /OPT:REF(删除未引用函数和数据)、/OPT:ICF(合并相同的 COMDAT)。
注:
--gc-sections对动态库要小心。默认情况下,导出到.dynsym的符号会被当作根保留;但如果用了版本脚本或-fvisibility=hidden把符号藏起来,链接器可能认为某些函数没人用而把它们删掉,结果运行时dlsym找不到。需要保留的入口要用__attribute__((used))、KEEP链接脚本规则或显式导出。
静态链接的产物
静态链接完成后,可执行文件里包含:
- 所有被引用的库代码的副本
- 已经填好的重定位(地址在链接时确定)
- 通常不再需要这些库文件就能运行
在 Linux 上,如果只静态链接了自己的库,仍然动态依赖 libc:
$ ldd app
	linux-vdso.so.1 (0x00007ffd...)
	libc.so.6 => /lib/x86_64-linux-gnu/libc.so.6 (0x00007f...)
	/lib64/ld-linux-x86-64.so.2 (0x00007f...)
如果加 -static,连 libc 也静态链接进去:
$ gcc main.o -L. -ladd -static -o app
$ ldd app
	not a dynamic executable
完全静态链接的代价:
- 文件体积大幅增加(libc 静态版本通常有几 MB)
- 每个进程都有一份独立的 libc 代码副本,物理内存不能共享
getaddrinfo、dlopen、iconv等依赖运行时加载的功能会退化或失效(glibc 的 NSS 需要动态加载libnss_*.so)- 许可证问题:glibc 是 LGPL,静态链接的分发义务比动态链接更严格;libstdc++ 有运行时例外(runtime exception),静态链接通常没问题,但商用前最好确认
C++ 项目里更常见的是"半静态":
g++ main.o -L. -ladd -static-libgcc -static-libstdc++ -o app只把 GCC 运行时和 libstdc++ 静态链进来,libc 仍然动态。这样部署时不用带 libstdc++.so.6,体积也不会失控。
1.3 动态库
定义与文件格式
动态库(dynamic library / shared library)是经过链接、可以在运行时被多个进程共享加载的库。
| 平台 | 后缀 | 格式 | 说明 |
|---|---|---|---|
| Linux | .so(shared object) |
ELF ET_DYN |
通常带版本号:libfoo.so.1.2.3 |
| Windows | .dll(dynamic-link library) |
PE | 通常还需要一个 .lib 导入库 |
| macOS | .dylib |
Mach-O | 安装名(install name)机制与 ELF 不同 |
| MinGW | .dll + .a 导入库 |
PE | 可以用 --out-implib 生成导入库 |
在 ELF 里,动态库和 PIE 可执行文件的类型都是 ET_DYN,区别在于:
- 动态库有
DT_SONAME,没有main,通常不作为程序入口 - PIE 可执行文件有入口点,带
DF_1_PIE标志,加载后跳到_start
$ readelf -h libadd.so
ELF Header:
  Type:                              DYN (Shared object file)
  Entry point address:               0x1040
  ...
ET_DYN 的意思是"位置无关的映像":文件里的地址都以 0 为基址,加载器把它映射到任意基址 B 后,所有内部相对引用仍然有效,只有那些记录在重定位表里的绝对地址需要加上 B。
链接时与运行时的两次解析
动态库最容易被误解的地方是"链接"发生了两次。
第一次:链接可执行文件时。
gcc main.o -L. -ladd -o app链接器看到 -ladd,找到 libadd.so,做这些事:
- 检查
libadd.so的.dynsym里有没有main.o需要的符号 - 把
libadd.so的DT_SONAME(比如libadd.so.1)写进可执行文件的DT_NEEDED - 在可执行文件里生成对应的 PLT/GOT 条目
- 不复制任何代码
链接完成后,app 里只留下"我需要 libadd.so.1"这条记录,以及调用点的 PLT 存根。
第二次:启动程序时。
内核执行 app,发现它有 PT_INTERP,于是先加载 /lib64/ld-linux-x86-64.so.2(动态加载器)。加载器:
- 读取
app的DT_NEEDED,找到libadd.so.1 - 按搜索路径找到实际文件,
mmap进地址空间 - 递归处理
libadd.so.1自己的DT_NEEDED - 处理重定位:把 GOT 项填成真实地址
- 执行各库的初始化函数(
.init_array) - 最后跳到
app的入口点
如果找不到库,程序根本起不来:
./app: error while loading shared libraries: libadd.so.1: cannot open shared object file: No such file or directory如果库找到了,但某个符号找不到:
./app: symbol lookup error: ./app: undefined symbol: _Z3addii注意这两种错误的区别:前者是加载器找不到文件,后者是文件找到了但符号对不上。
注:Linux 的链接器默认允许动态库带未定义符号(
--allow-shlib-undefined)。也就是说,gcc -shared生成一个引用了不存在符号的.so可以成功,错误推迟到运行时。Windows 的链接器默认不允许,必须在链接时把所有导入解析掉(除非用/FORCE:UNRESOLVED或延迟加载)。如果你想让 Linux 也尽早发现这类问题,链接动态库时加-Wl,--no-undefined(等价于-Wl,-z,defs)。
位置无关代码
动态库要被加载到任意地址,就必须是位置无关代码(PIC,Position-Independent Code)。理解 PIC 的关键是区分两类地址:
- 相对地址:
call指令里的 32 位偏移、lea rax, [rip+0x1234]里的 RIP 相对偏移。这类地址只依赖"当前指令到目标"的距离,整个模块平移后距离不变,不需要修改。 - 绝对地址:
mov rax, 0x400800这种把地址当立即数写进指令的编码。模块一旦被加载到别的基址,这个立即数就错了,必须重定位。
PIC 的做法是:尽量不用绝对地址;必须用到时,把地址放在 GOT 里,代码通过 RIP 相对寻址去 GOT 取。
看一段实际代码:
// lib.cpp
extern int g_count;

int get_count()
{
    return g_count;
}

int call_add(int a, int b);
int call_it(int a, int b)
{
    return call_add(a, b);
}
不加 -fPIC 编译:
g++ -O2 -c lib.cpp -o lib_nopic.o
objdump -dr lib_nopic.o
0000000000000000 <_Z9get_countv>:
0: 8b 05 00 00 00 00 mov eax,DWORD PTR [rip+0x0]
2: R_X86_64_PC32 g_count-0x4
6: c3 ret
0000000000000007 <_Z7call_itii>:
7: e9 00 00 00 00 jmp 0xc <_Z7call_itii+0x5>
8: R_X86_64_PLT32 _Z8call_addii-0x4加 -fPIC 编译:
g++ -O2 -fPIC -c lib.cpp -o lib_pic.o
objdump -dr lib_pic.o
0000000000000000 <_Z9get_countv>:
0: 48 8b 05 00 00 00 00 mov rax,QWORD PTR [rip+0x0]
3: R_X86_64_REX_GOTPCRELX g_count-0x4
7: 8b 00 mov eax,DWORD PTR [rax]
9: c3 ret
000000000000000a <_Z7call_itii>:
a: e9 00 00 00 00 jmp 0xf <_Z7call_itii+0x5>
b: R_X86_64_PLT32 _Z8call_addii-0x4区别在于访问 g_count:非 PIC 版本用一条 mov eax, [rip+偏移] 直接读;PIC 版本先用 mov rax, [rip+GOT偏移] 从 GOT 里取出 g_count 的地址,再 mov eax, [rax] 解引用。多了一次内存访问。
为什么连自己库里的全局变量也要走 GOT?因为 ELF 默认允许符号插入(symbol interposition):可执行文件或 LD_PRELOAD 里可以定义同名符号覆盖库里的定义,库内部的引用也必须走全局查找才能尊重这个规则。如果确定不需要插入,可以用 -fno-semantic-interposition(GCC 5+ / Clang)、-Bsymbolic 或隐藏可见性来恢复直接访问。
编译动态库时必须加 -fPIC(或 -fpic)。在 x86-64 上两者基本等价;在 i386 上 -fpic 的 GOT 更小、有 32KB 限制,-fPIC 没有限制但代码更大。忘记加会得到:
/usr/bin/ld: lib.o: relocation R_X86_64_32S against symbol `g_count' can not be used when making a shared object; recompile with -fPICPIC 的性能代价通常在 1% 到 3% 之间,具体取决于代码里全局变量和跨模块调用的密度。对性能敏感的库,可以用 -fvisibility=hidden 把内部符号藏起来,让编译器知道"这个符号不会被插入",从而生成直接访问。
PIE 可执行文件用的是 -fPIE,它和 -fPIC 的代码生成策略相似,但 PIE 知道自己就是程序本身,可以对某些符号做更激进的优化。现代发行版大多默认开启 PIE(gcc -v 里能看到 --enable-default-pie),所以你在桌面 Linux 上编译出的可执行文件通常也是 ET_DYN。
GOT 与 PLT
GOT(Global Offset Table,全局偏移表)是一张放在可写数据段里的指针数组,每个需要动态解析的符号占一项。PLT(Procedure Linkage Table,过程链接表)是一小段代码存根,负责"第一次调用时触发解析,之后直接跳转"。
先看调用一个动态库函数的完整链路。假设 app 调用了 libadd.so 里的 add:
app 的 .text:
    call add@plt
        │
        ▼
app 的 .plt:
  add@plt:
    jmp QWORD PTR [add@got.plt]   ; 第一次跳回下一条指令,之后跳真实地址
    push 0                        ; 重定位索引
    jmp plt0                      ; 跳到公共存根
  plt0:
    push QWORD PTR [got+8]        ; link_map
    jmp QWORD PTR [got+16]        ; _dl_runtime_resolve
第一次调用时:
add@got.plt里存的是add@plt+6,也就是push 0那条指令的地址- 于是执行
push 0,把重定位索引压栈 - 跳到
plt0,压入link_map,跳到_dl_runtime_resolve - 解析器在全局符号表里找到
add的真实地址 - 把真实地址写回
add@got.plt - 跳到
add执行
第二次调用时,add@got.plt 里已经是真实地址,jmp 直接过去,只剩一次间接跳转的开销。
这就是懒绑定(lazy binding):符号解析推迟到第一次调用,减少启动时间。代价是第一次调用要付出解析开销,而且 GOT 必须保持可写。
用 objdump -d 能看到 PLT 的机器码:
0000000000001030 <add@plt>:
    1030:   ff 25 e2 2f 00 00       jmp    QWORD PTR [rip+0x2fe2]   # 4018 <add@got.plt>
    1036:   68 00 00 00 00          push   0x0
    103b:   e9 e0 ff ff ff          jmp    1020 <plt0>
如果链接时加 -Wl,-z,now(或设置环境变量 LD_BIND_NOW=1),所有符号在加载时一次性解析完,GOT 填好后立刻被 mprotect 成只读。这叫立即绑定(immediate binding),配合 -Wl,-z,relro 就是 Full RELRO。它牺牲一点启动时间,换取 GOT 不可被改写,是很多安全加固方案的默认配置。
注:Full RELRO 和懒绑定不能共存。
-z now会让.got.plt在重定位后并入只读的 RELRO 段,之后无法再写入解析结果,所以所有 PLT 项必须在加载时解析完。
数据符号不能懒绑定。访问动态库里的全局变量时,代码直接从 GOT 取值:
mov rax, QWORD PTR [rip+g_count@GOTPCREL]
mov eax, DWORD PTR [rax]
GOT 项在加载时由 R_X86_64_GLOB_DAT 重定位填好。所以"变量访问"比"函数调用"少一层 PLT,但多一次内存解引用。
如果想完全去掉 PLT 那一跳,可以用 -fno-plt 编译:
call QWORD PTR [rip+add@GOTPCREL]直接通过 GOT 间接调用,省掉 jmp,也让懒绑定失效(因为调用点直接读 GOT,GOT 必须在加载时填好)。一些发行版(如 Fedora)已经在部分构建中默认使用 -fno-plt。
符号插入与查找作用域
ELF 的动态符号解析遵循"全局作用域、先到先得":
- 可执行文件自己的符号优先
- 然后是
LD_PRELOAD预加载的库 - 然后是
DT_NEEDED按加载顺序排列的依赖 - 最后是
dlopen进来的库(如果用了RTLD_GLOBAL)
这意味着,如果 libfoo.so 内部调用自己的 foo(),而可执行文件里也定义了一个 foo(),实际被调用的是可执行文件里的版本。这个机制叫符号插入(symbol interposition),它支撑了 LD_PRELOAD 这种"不修改程序就替换函数"的用法,也会带来难以排查的行为差异。
# 用自己写的 malloc 替换 libc 的 malloc
LD_PRELOAD=./mymalloc.so ./app
如果库作者不希望自己的内部符号被插入,有三条路:
- 隐藏可见性:编译时
-fvisibility=hidden,只给公开 API 加__attribute__((visibility("default"))) - 链接时绑定:
-Wl,-Bsymbolic或-Wl,-Bsymbolic-functions,让库内部引用优先绑定到自己的定义 - 版本脚本:用
local: *;把非导出符号全部藏起来
Windows 的模型完全不同:DLL 的导入表按"模块 + 名字"绑定,不存在全局符号空间,也不存在 LD_PRELOAD 式的插入。这是后面"dll 隔离"一节要展开的内容。
动态加载器
Linux 的动态加载器是 ld.so(路径通常是 /lib64/ld-linux-x86-64.so.2)。它本身也是一个共享对象,由内核根据可执行文件的 PT_INTERP 段自动加载。
启动链路大致是:
execve("./app")
   │
   ├─ 内核读取 ELF 头,发现 PT_INTERP
   ├─ 映射 ld.so 和 app 的 PT_LOAD 段
   ├─ 把控制权交给 ld.so 的入口
   │
   ▼
ld.so:
   ├─ 自我重定位
   ├─ 读取 app 的 DT_NEEDED,递归加载依赖
   ├─ 建立链接映射(link_map)和全局符号表
   ├─ 处理 .rela.dyn / .rela.plt(立即绑定或延迟)
   ├─ 执行各对象的 .init_array
   └─ 跳到 app 的入口 _start
        │
        ▼
_start → __libc_start_main → main
库的搜索顺序(简化):
DT_RPATH(如果存在且没有DT_RUNPATH)——已废弃LD_LIBRARY_PATH环境变量DT_RUNPATH(-Wl,-rpath生成,现代默认是 RUNPATH)/etc/ld.so.cache(由ldconfig维护)- 默认目录:
/lib、/usr/lib、/lib64、/usr/lib64(随发行版而异)
RPATH 和 RUNPATH 的区别是一个经典陷阱:RPATH 在 LD_LIBRARY_PATH 之前搜索,RUNPATH 在之后。很多发行版默认把 -rpath 生成为 RUNPATH(--enable-new-dtags),所以你以为写死的路径会被环境变量覆盖——有时候这正好是想要的,有时候正好相反。可以用 readelf -d app | grep -E 'RPATH|RUNPATH' 确认。
$ORIGIN 是 rpath 里的特殊变量,表示"当前对象所在目录",常用来做免安装的相对路径:
gcc main.o -L. -ladd -Wl,-rpath,'$ORIGIN/lib' -o app单引号是必须的,否则 shell 会把 $ORIGIN 展开成空字符串。
动态库的初始化与析构
动态库被加载时,加载器会执行它的初始化代码。ELF 提供两套机制:
- 老式的
DT_INIT/DT_FINI,对应_init/_fini函数 - 现代的
.init_array/.fini_array,是一组函数指针数组
GCC 的 __attribute__((constructor)) 和 __attribute__((destructor)) 会往这两个数组里放指针:
__attribute__((constructor))
void lib_init()
{
    // 库加载时执行
}

__attribute__((destructor))
void lib_fini()
{
    // 库卸载或进程退出时执行
}
C++ 的全局对象构造函数也是通过 .init_array 执行的。这就带来一个常见问题:不同翻译单元之间的全局对象初始化顺序没有保证。如果 libA 的全局对象构造函数调用了 libB 的全局对象,而 libB 还没初始化,就会读到未构造的对象。这叫静态初始化顺序问题(static initialization order fiasco)。
动态库之间的初始化顺序由依赖关系决定:如果 A 依赖 B,B 先初始化。但两个互不依赖的库之间,顺序取决于加载顺序,不要依赖它。
Windows 的动态库
Windows 的 DLL 和 ELF 共享库解决的是同一个问题,但机制差别很大:
Linux .so |
Windows .dll |
|
|---|---|---|
| 链接输入 | .so 本身 |
.lib 导入库 |
| 符号解析 | 运行时按名字全局查找 | 加载时按导入表绑定到具体模块 |
| 导出方式 | 默认全部全局符号可见 | 必须显式导出(__declspec(dllexport) 或 .def) |
| 函数调用 | 经过 PLT/GOT | 经过 IAT(导入地址表) |
| 懒绑定 | 支持 | 不支持(延迟加载是另一套机制) |
| 符号插入 | 支持 | 不支持 |
| 版本机制 | soname + 符号版本 | 文件名 / manifest / SxS |
Windows 的加载器在启动时:
- 读取 EXE 的导入表,得到需要加载的 DLL 列表
- 递归加载这些 DLL(按搜索路径)
- 为每个 DLL 分配基址,如果首选基址被占用就重定位(前提是有
.reloc段) - 遍历导入表,把每个函数的真实地址写进 IAT
- 调用每个 DLL 的
DllMain(DLL_PROCESS_ATTACH) - 跳到 EXE 入口
DLL 的函数调用在机器码层面是:
call QWORD PTR [__imp_add] ; 直接通过 IAT 间接调用或者(没有 dllimport 时):
call add                        ; 调用导入库提供的 thunk
add_thunk:
    jmp QWORD PTR [__imp_add]
这两种形式的细节在实操篇里展开。
1.4 静态库与动态库对比
把上面的内容整理成一张表:
| 维度 | 静态库 | 动态库 |
|---|---|---|
| 常见后缀 | .a / .lib(静态) |
.so / .dll / .dylib + .lib(导入) |
| 本质 | .o 的归档包 |
已链接的 ELF/PE 映像 |
| 生成命令 | ar rcs / lib |
gcc -shared / link /DLL |
| 代码是否复制 | 是,复制进 exe | 否,运行时映射 |
| 符号解析时机 | 链接时 | 链接时检查 + 加载时绑定 |
| 地址确定时机 | 链接时 | 加载时加基址 + 重定位 |
| 是否需要 PIC | 否(PIE 除外) | 是(x86-64) |
| 运行时依赖 | 无(除 libc 等) | 必须有对应的 .so / .dll |
| 进程间共享 | 不能共享代码页 | 代码页可共享,数据页私有 |
| 更新方式 | 重新链接整个程序 | 替换库文件(ABI 兼容时) |
| 体积 | 每个 exe 各存一份,总体偏大 | 库单独一份,多个 exe 共享 |
| 启动开销 | 较小 | 加载、重定位、符号解析 |
| 调用开销 | 直接调用,最小 | PLT/GOT 或 IAT 间接跳转 |
| 符号冲突处理 | 链接时按强弱/顺序解决 | 运行时按作用域先到先得(ELF) |
| 导出机制 | 所有全局符号 | ELF 默认全部 / PE 必须显式 |
| 版本管理 | 无(靠文件名/目录) | soname / 符号版本 / manifest |
| 典型错误 | undefined reference、重复定义 |
cannot open shared object、undefined symbol |
| 适用场景 | 工具、嵌入式、单文件分发、启动敏感 | 系统库、插件、多程序共享、热更新 |
没有绝对的优劣,只有取舍:
- 静态库把"依赖"消灭在链接期。产物自包含、启动快、调用直接、部署简单,代价是体积重复、更新要重链、无法在运行时替换。
- 动态库把"依赖"推迟到运行期。多程序共享一份代码、更新库不用动程序、支持插件和运行时加载,代价是加载开销、ABI 约束、部署时得把库带对。
一个常见的工程折中是:内部用静态库组织代码,对外发布时链接成一个动态库或可执行文件。这样开发时模块清晰、增量编译快,发布时又只暴露一个稳定的二进制接口。
2. 库文件详解
前面把库当成黑盒,只关心它"能提供什么"。这一节把文件拆开,看看里面到底有什么,以及这些结构如何决定链接和加载的行为。
2.1 拆开一个静态库
静态库的结构最简单:一个魔数,一串成员,外加一张索引。用 ar 就能直接操作。
$ ar t libadd.a
add.o
sub.o
util.o

$ ar tv libadd.a
rw-r--r-- 0/0   1234 Jan  1 00:00 1970 add.o
rw-r--r-- 0/0    986 Jan  1 00:00 1970 sub.o
rw-r--r-- 0/0   2048 Jan  1 00:00 1970 util.o
ar tv 的输出列出了成员名、大小、时间戳、属主。时间戳全是 1970,这是确定性归档(D 模式)的特征。
从字节层面看,一个 GNU ar 归档长这样:
偏移 0
┌────────────────────────────────────────────┐
│ "!<arch>\n"                                 │  8 字节全局魔数
├────────────────────────────────────────────┤
│ 成员头 1(60 字节)                          │
│   name[16] date[12] uid[6] gid[6]           │
│   mode[8] size[10] fmag[2] = "`\n"         │
├────────────────────────────────────────────┤
│ 成员 1 的数据(按偶数边界对齐,奇数补 \n)      │
├────────────────────────────────────────────┤
│ 成员头 2(60 字节)                          │
├────────────────────────────────────────────┤
│ 成员 2 的数据                                │
└────────────────────────────────────────────┘
成员名字段只有 16 字节。短名字直接写;长名字有两种扩展方式:
- GNU 风格:名字写成
/偏移,真正的字符串放在一个名为//的特殊成员里 - BSD 风格:名字写成
#1/长度,真实名字放在成员数据开头
GNU ar 还会插入一个名为 / 的成员,里面是符号索引(symbol index,也叫 armap)。它的结构大致是:
┌──────────────────────────────────────┐
│ 大端 32 位:符号个数 N                 │
├──────────────────────────────────────┤
│ N 个 32 位大端偏移(每个符号对应的成员头位置) │
├──────────────────────────────────────┤
│ N 个以 \0 结尾的符号名                  │
└──────────────────────────────────────┘
链接器打开 libadd.a 时,先读这张索引,建立一个"符号名 → 成员"的哈希表。之后每遇到一个未定义符号,直接查表取出对应成员。没有索引也能链接,但链接器就得逐个扫描成员,速度慢很多。
ar s、ranlib、ar rcs 里的 s 都是在重建这张索引。用 nm -sC libadd.a 可以看到索引内容:
Archive index:
add(int, int) in add.o
sub(int, int) in add.o
helper() in util.o

add.o:
0000000000000000 T add(int, int)
0000000000000020 T sub(int, int)

util.o:
0000000000000000 T helper()注:GNU ar 支持瘦归档(thin archive):
ar T创建的文件里不存成员内容,只存成员文件的路径。链接时链接器按路径去读原始.o。大型项目用它避免反复复制体积巨大的目标文件。瘦归档不能单独分发——目标文件丢了,归档就废了。
Windows 的 .lib 静态库在结构上也是 COFF 归档,但成员头部格式不同,还多了两个链接器成员(第一个存符号索引,第二个存成员偏移),以及一个 // 长名字成员。用 lib /list add.lib 可以列出成员,dumpbin /symbols add.lib 可以看符号。
2.2 拆开一个目标文件
.o 是 ELF 可重定位文件。它的头部(readelf -h)告诉你这是一张"还没定地址的图纸":
$ readelf -h add.o
ELF Header:
  Magic:   7f 45 4c 46 02 01 01 00 00 00 00 00 00 00 00 00
  Class:                             ELF64
  Data:                              2's complement, little endian
  Type:                              REL (Relocatable file)
  Machine:                           Advanced Micro Devices X86-64
  Entry point address:               0x0
  Start of program headers:          0 (bytes into file)
  Start of section headers:          744 (bytes into file)
  Number of section headers:         13
两个关键字段:
Type: REL:可重定位文件,地址还没定Entry point: 0x0:没有入口点,不能执行Start of program headers: 0:没有程序头,因为加载器不需要它(可重定位文件不直接被加载)
节区与标志
readelf -SW 会列出所有节区和它们的标志(Flg):
| 标志 | 含义 | 影响 |
|---|---|---|
A |
ALLOC | 加载时占用内存 |
W |
WRITE | 可写 |
X |
EXECINSTR | 可执行 |
M |
MERGE | 可合并(如字符串常量) |
S |
STRINGS | 合并时按字符串比较 |
G |
GROUP | COMDAT 组 |
T |
TLS | 线程局部存储 |
C |
COMPRESSED | 压缩过的调试节区 |
I |
INFO | 链接器信息 |
L |
LINK_ORDER | 保持链接顺序 |
O |
OS-specific | 操作系统保留 |
一个典型 .o 的节区职责:
.text            机器指令
.rodata          只读常量、字符串字面量、跳转表
.data            已初始化的可写变量
.bss             未初始化的可写变量(不占文件空间)
.tdata/.tbss     thread_local 变量
.init_array      构造函数指针数组
.fini_array      析构函数指针数组
.eh_frame        异常展开表(记录每个函数的栈帧布局)
.gcc_except_table 异常捕获表(try/catch 的匹配信息)
.symtab          符号表
.strtab          符号名字符串表
.rela.text       .text 的重定位表
.rela.data       .data 的重定位表
.rela.eh_frame   .eh_frame 的重定位表
.group           COMDAT 组(模板、内联函数)
.note.GNU-stack  标记栈是否可执行
.note.gnu.property 硬件特性(CET、IBT、SHSTK)
.comment         编译器版本
.debug_*         调试信息(-g)
几个细节值得展开。
1. .rodata 里的字符串会合并。 编译器给字符串常量分配节区 .rodata.str1.1,带 SHF_MERGE | SHF_STRINGS 标志。链接器把所有相同的字符串合并成一份,减少体积:
const char* a = "hello";
const char* b = "hello";    // 链接后 a 和 b 指向同一个地址
这个优化在标准里没有保证,但主流工具链都会做。不要依赖它,也不要依赖"它们地址不同"。
2. .bss 的 sh_offset 通常等于下一个节区的偏移。 因为它不占文件空间,sh_size 只表示"加载后要占多少内存"。在程序头里表现为 p_memsz > p_filesz:
LOAD 0x002dd0 0x3dd0 0x3dd0 0x000280 0x000288 RW 0x1000
                                       ^^^^^^^^ 文件里只占 0x280
                                                ^^^^^^^^ 内存里占 0x288,多出的 8 字节就是 .bss
3. .data.rel.ro 是"加载时只读"。 它存放需要在加载时重定位、但之后不该被写的指针表,比如虚函数表、const 对象里的指针。动态库加载器处理完重定位后,会通过 PT_GNU_RELRO 把它 mprotect 成只读。
4. COMDAT 组解决模板和内联函数的重复定义。 头文件里的模板函数在每个包含它的翻译单元里都会实例化一份,天然违反"一个定义"规则。编译器把每个实例放进一个 .group 节区,组签名是修饰后的符号名,链接器只保留一份,其余丢弃:
$ readelf -g add.o
COMDAT group section [    1] `.group' [_Z3maxIiET_S0_S0_] contains 1 section:
   [Index] Name
   [    4] .text._Z3maxIiET_S0_S0_
5. .note.GNU-stack 决定栈是否可执行。 现代工具链默认标记为"不可执行",加载后栈页只有读写权限。如果某个汇编文件没加这个标记,链接器会警告 missing .note.GNU-stack section implies executable stack,并生成可执行栈——这是一个安全隐患。
6. .note.gnu.property 记录 CPU 特性。 开启 -fcf-protection 时,里面会标记 GNU_PROPERTY_X86_FEATURE_1_IBT(间接分支跟踪)和 SHSTK(影子栈)。动态加载器会检查所有模块的属性;不一致时可能拒绝加载,也可能关闭相应保护,具体行为取决于内核和加载器版本。这是 CET 相关的"模块属性不匹配"错误来源。
符号表的结构
.symtab 是一个 Elf64_Sym 数组,每项 24 字节:
struct Elf64_Sym {
    Elf64_Word  st_name;    // 符号名在 .strtab 中的偏移
    unsigned char st_info;  // 类型(低 4 位)+ 绑定(高 4 位)
    unsigned char st_other; // 可见性(低 2 位)
    Elf64_Section st_shndx; // 所属节区索引,UND/ABS/COM 是特殊值
    Elf64_Addr  st_value;   // 在节区内的偏移(可重定位文件)
    Elf64_Xword st_size;    // 大小
};
st_info 的低 4 位是类型(STT_FUNC、STT_OBJECT、STT_SECTION、STT_FILE、STT_TLS),高 4 位是绑定(STB_LOCAL、STB_GLOBAL、STB_WEAK、STB_GNU_UNIQUE)。st_other 的低 2 位是可见性(STV_DEFAULT、STV_INTERNAL、STV_HIDDEN、STV_PROTECTED)。
特殊节区索引:
SHN_UNDEF(0):未定义SHN_ABS(0xfff1):绝对值,不随重定位变化SHN_COMMON(0xfff2):公共符号,链接时分配SHN_XINDEX(0xffff):真实索引在.symtab_shndx里
公共符号(common symbol)是老式 C 的"暂定定义"机制:
int x;    // 暂定定义,可能进 COMMON
int x = 1; // 强定义,进 .data
GCC 默认 -fno-common(GCC 10 起),未初始化的全局变量直接进 .bss,不再生成 COMMON 符号。老代码里多个文件都写 int x; 能链接通过,靠的就是 COMMON 合并;开启 -fno-common 后同样的代码会报重复定义。
重定位表的结构
ELF64 的重定位项 Elf64_Rela 也是 24 字节:
struct Elf64_Rela {
    Elf64_Addr  r_offset;   // 要修改的位置(节区内偏移,或加载后的虚拟地址)
    Elf64_Xword r_info;     // 符号索引(高 32 位)+ 类型(低 32 位)
    Elf64_Sxword r_addend;  // 加数
};
r_offset 的语义随文件类型变化:
- 可重定位文件(
.o):相对于节区起始的偏移 - 可执行文件/动态库:加载后的虚拟地址
r_addend 是链接时加到符号值上的常数。前面 call 指令的例子用 -4 修正"相对下一条指令"的基准。
用 readelf -rW 看完整的重定位表:
$ readelf -rW add.o

Relocation section '.rela.text' at offset 0x2b8 contains 2 entries:
    Offset             Info             Type               Symbol's Value  Symbol's Name + Addend
0000000000000005  0000000400000002 R_X86_64_PC32          0000000000000000 .rodata - 4
000000000000001a  0000000900000004 R_X86_64_PLT32         0000000000000000 _Z3subii - 4

Relocation section '.rela.eh_frame' at offset 0x2e8 contains 1 entry:
    Offset             Info             Type               Symbol's Value  Symbol's Name + Addend
0000000000000020  0000000200000002 R_X86_64_PC32          0000000000000000 .text + 0
注意 .rela.text 的第一条:符号是 .rodata 这个节区符号,不是某个具体变量。这是因为字符串常量的地址在编译时只需要知道"相对 .rodata 开头的偏移",链接器合并 .rodata 后再修正。
为什么 .o 不能直接运行
把 .o 的权限改成可执行然后运行:
chmod +x add.o
./add.o
bash: ./add.o: cannot execute a relocatable file内核看到 ET_REL 就直接拒绝。原因很直接:
- 没有程序头,加载器不知道该映射哪些段、给什么权限
- 没有入口点
- 节区地址全是 0,指令里的重定位还没填
- 没有
PT_INTERP,即使能加载也不知道怎么启动
.o 是给链接器看的半成品,不是给内核看的成品。
2.3 拆开一个动态库
动态库是完整的 ELF 映像,结构比 .o 复杂得多。下面按"加载器会看什么"的顺序拆。
ELF 头与程序头
$ readelf -h libadd.so
ELF Header:
  Type:                              DYN (Shared object file)
  Machine:                           Advanced Micro Devices X86-64
  Entry point address:               0x1040
  Start of program headers:          64 (bytes into file)
  Number of program headers:         10
  Start of section headers:          15136 (bytes into file)
  Number of section headers:         27
Type: DYN 说明它是位置无关映像。Entry point 对共享库没有实际意义(dlopen 不会跳过去),但链接器仍会填一个值。
程序头(readelf -lW)告诉加载器怎么映射:
$ readelf -lW libadd.so

Elf file type is DYN (Shared object file)
Entry point 0x1040
There are 10 program headers, starting at offset 64

Program Headers:
  Type           Offset   VirtAddr           PhysAddr           FileSiz  MemSiz   Flg Align
  LOAD           0x000000 0x0000000000000000 0x0000000000000000 0x0006e8 0x0006e8 R   0x1000
  LOAD           0x001000 0x0000000000001000 0x0000000000001000 0x0001d1 0x0001d1 R E 0x1000
  LOAD           0x002000 0x0000000000002000 0x0000000000002000 0x0000e8 0x0000e8 R   0x1000
  LOAD           0x002dd0 0x0000000000003dd0 0x0000000000003dd0 0x000280 0x000288 RW  0x1000
  DYNAMIC        0x002e10 0x0000000000003e10 0x0000000000003e10 0x0001e0 0x0001e0 RW  0x8
  NOTE           0x000238 0x0000000000000238 0x0000000000000238 0x000044 0x000044 R   0x8
  GNU_PROPERTY   0x000238 0x0000000000000238 0x0000000000000238 0x000020 0x000020 R   0x8
  GNU_EH_FRAME   0x002010 0x0000000000002010 0x0000000000002010 0x000034 0x000034 R   0x4
  GNU_STACK      0x000000 0x0000000000000000 0x0000000000000000 0x000000 0x000000 RW  0x10
  GNU_RELRO      0x002dd0 0x0000000000003dd0 0x0000000000003dd0 0x000230 0x000230 R   0x1
几个关键点:
- 四个
LOAD段分别对应"只读头/元数据"、“代码”、“只读数据”、“可写数据”。 加载器按Flg给不同的页权限:R只读、R E读+执行、RW读+写。这就是 W^X(写与执行互斥)的落地方式。 Offset和VirtAddr对 4KB 对齐的段满足Offset % 0x1000 == VirtAddr % 0x1000。 加载器才能用mmap直接把文件页映射进来,不用逐字节拷贝。- 第四个
LOAD的MemSiz比FileSiz大 8 字节,多出来的是.bss。加载器为这段区域补匿名零页。 GNU_RELRO覆盖.init_array、.fini_array、.dynamic、.got等区域。 加载器处理完重定位后,把这段改成只读。GNU_STACK的RW表示栈不可执行。如果某个目标文件缺少.note.GNU-stack,这里会变成RWE。
节区表
$ readelf -SW libadd.so
There are 27 section headers, starting at offset 0x3b20:

  [Nr] Name              Type            Address          Off    Size   ES Flg Lk Inf Al
  [ 0]                   NULL            0000000000000000 000000 000000 00      0   0  0
  [ 1] .note.gnu.property NOTE            0000000000000238 000238 000020 00   A  0   0  8
  [ 2] .note.gnu.build-id NOTE            0000000000000258 000258 000024 00   A  0   0  4
  [ 3] .gnu.hash         GNU_HASH        000000000000027c 00027c 00001c 00   A  6   0  4
  [ 4] .dynsym           DYNSYM          0000000000000298 000298 0000a8 18   A  5   1  8
  [ 5] .dynstr           STRTAB          0000000000000340 000340 000085 00   A  0   0  1
  [ 6] .gnu.version      VERSYM          00000000000003c6 0003c6 00000e 02   A  4   0  2
  [ 7] .gnu.version_r    VERNEED         00000000000003d4 0003d4 000030 00   A  5   1  8
  [ 8] .rela.dyn         RELA            0000000000000408 000408 0000c0 18   A  4   0  8
  [ 9] .rela.plt         RELA            00000000000004c8 0004c8 000018 18  AI  4  22  8
  [10] .init             PROGBITS        0000000000001000 001000 000017 00  AX  0   0  4
  [11] .plt              PROGBITS        0000000000001020 001020 000020 10  AX  0   0 16
  [12] .text             PROGBITS        0000000000001050 001050 000175 00  AX  0   0 16
  [13] .fini             PROGBITS        00000000000011c8 0011c8 000009 00  AX  0   0  4
  [14] .rodata           PROGBITS        0000000000002000 002000 000010 00   A  0   0  4
  [15] .eh_frame_hdr     PROGBITS        0000000000002010 002010 000034 00   A  0   0  4
  [16] .eh_frame         PROGBITS        0000000000002048 002048 0000a0 00   A  0   0  8
  [17] .init_array       INIT_ARRAY      0000000000003dd0 002dd0 000008 08  WA  0   0  8
  [18] .fini_array       FINI_ARRAY      0000000000003dd8 002dd8 000008 08  WA  0   0  8
  [19] .data.rel.ro      PROGBITS        0000000000003de0 002de0 000030 00  WA  0   0  8
  [20] .dynamic          DYNAMIC         0000000000003e10 002e10 0001e0 10  WA  6   0  8
  [21] .got              PROGBITS        0000000000003ff0 002ff0 000020 08  WA  0   0  8
  [22] .got.plt          PROGBITS        0000000000004010 003010 000020 08  WA  0   0  8
  [23] .data             PROGBITS        0000000000004030 003030 000010 00  WA  0   0  8
  [24] .bss              NOBITS          0000000000004040 003040 000008 00  WA  0   0  1
  [25] .comment          PROGBITS        0000000000000000 003040 00002b 01  MS  0   0  1
和 .o 相比,多了这些关键节区:
| 节区 | 作用 |
|---|---|
.dynsym |
动态符号表,运行时符号解析用;只含需要跨模块可见的符号 |
.dynstr |
动态符号的名字字符串 |
.gnu.hash |
GNU 风格的符号哈希表,比老的 .hash 快 |
.gnu.version |
每个动态符号的版本索引 |
.gnu.version_r |
依赖库的版本需求(verneed) |
.gnu.version_d |
本库定义的版本(verdef) |
.rela.dyn |
数据重定位,加载时必须处理 |
.rela.plt |
函数跳转槽重定位,可延迟处理 |
.dynamic |
动态段的入口,列出所有动态信息 |
.got |
数据符号的地址表 |
.got.plt |
函数符号的地址表(懒绑定时可写) |
.plt |
函数跳转存根 |
.init_array |
构造函数数组 |
.fini_array |
析构函数数组 |
.data.rel.ro |
需重定位的只读数据,加载后由 RELRO 保护 |
注意 .symtab 不在列表里——动态库可以只有 .dynsym,.symtab 是可选的调试信息。strip删掉.symtab和.debug_*` 后,动态库仍然能正常链接和加载。
动态段
.dynamic 是一个 Elf64_Dyn 数组,每项是"标签 + 值"。加载器主要靠它工作:
$ readelf -dW libadd.so

Dynamic section at offset 0x2e10 contains 25 entries:
  Tag        Type                         Name/Value
 0x0000000000000001 (NEEDED)             Shared library: [libstdc++.so.6]
 0x0000000000000001 (NEEDED)             Shared library: [libc.so.6]
 0x000000000000000e (SONAME)             Library soname: [libadd.so.1]
 0x000000000000000c (INIT)               0x1000
 0x000000000000000d (FINI)               0x11c8
 0x0000000000000019 (INIT_ARRAY)         0x3dd0
 0x000000000000001b (INIT_ARRAYSZ)       8 (bytes)
 0x000000000000001a (FINI_ARRAY)         0x3dd8
 0x000000000000001c (FINI_ARRAYSZ)       8 (bytes)
 0x000000006ffffef5 (GNU_HASH)           0x27c
 0x0000000000000005 (STRTAB)             0x340
 0x0000000000000006 (SYMTAB)             0x298
 0x000000000000000a (STRSZ)              133 (bytes)
 0x000000000000000b (SYMENT)             24 (bytes)
 0x0000000000000003 (PLTGOT)             0x4010
 0x0000000000000002 (PLTRELSZ)           24 (bytes)
 0x0000000000000014 (PLTREL)             RELA
 0x0000000000000017 (JMPREL)             0x4c8
 0x0000000000000007 (RELA)               0x408
 0x0000000000000008 (RELASZ)             192 (bytes)
 0x0000000000000009 (RELAENT)            24 (bytes)
 0x000000000000001d (RUNPATH)            Library runpath: [$ORIGIN]
 0x000000006ffffffb (FLAGS_1)            Flags: NOW
 0x000000006ffffffe (VERNEED)            0x3d4
 0x000000006fffffff (VERNEEDNUM)         1
 0x000000006ffffff0 (VERSYM)             0x3c6
 0x0000000000000000 (NULL)               0x0
常见标签:
| 标签 | 含义 |
|---|---|
NEEDED |
依赖的共享库(记录 soname) |
SONAME |
本库的 soname |
RPATH / RUNPATH |
运行时库搜索路径 |
INIT / FINI |
老式初始化/析构函数地址 |
INIT_ARRAY / INIT_ARRAYSZ |
构造函数数组及大小 |
FINI_ARRAY / FINI_ARRAYSZ |
析构函数数组及大小 |
SYMTAB |
动态符号表地址 |
STRTAB |
动态字符串表地址 |
GNU_HASH |
GNU 哈希表地址 |
RELA / RELASZ |
数据重定位表 |
JMPREL / PLTRELSZ |
PLT 重定位表 |
PLTGOT |
GOT 起始地址 |
FLAGS / FLAGS_1 |
绑定方式(NOW)、PIE、ORIGIN 等 |
VERDEF / VERNEED / VERSYM |
符号版本信息 |
DEBUG |
指向 r_debug,调试器用来遍历已加载模块 |
注:
DT_NEEDED记录的是依赖库的SONAME,不是文件名。这就是为什么运行时找不到库的报错里出现的是libadd.so.1,而不是你链接时写的libadd.so。
动态符号表与哈希
.dynsym 和 .symtab 结构一样,但只包含动态链接需要的符号:
$ readelf --dyn-syms -W libadd.so

Symbol table '.dynsym' contains 8 entries:
   Num:    Value          Size Type    Bind   Vis      Ndx Name
     0: 0000000000000000     0 NOTYPE  LOCAL  DEFAULT  UND
     1: 0000000000000000     0 NOTYPE  WEAK   DEFAULT  UND _ITM_deregisterTMCloneTable
     2: 0000000000000000     0 FUNC    GLOBAL DEFAULT  UND _ZdlPv@GLIBCXX_3.4 (2)
     3: 0000000000000000     0 NOTYPE  WEAK   DEFAULT  UND __gmon_start__
     4: 0000000000000000     0 NOTYPE  WEAK   DEFAULT  UND _ITM_registerTMCloneTable
     5: 0000000000000000     0 FUNC    WEAK   DEFAULT  UND __cxa_finalize@GLIBC_2.2.5 (3)
     6: 0000000000001109    18 FUNC    GLOBAL DEFAULT   12 _Z3addii
     7: 000000000000111b    18 FUNC    GLOBAL DEFAULT   12 _Z3subii
第 0 项永远是空符号。带 UND 的是需要运行时解析的导入符号;带具体地址的是本库导出的符号。名字后面的 @GLIBCXX_3.4 是符号版本,表示这个引用需要 libstdc++ 提供该版本的符号。
加载器要在几百个符号里快速找到目标,靠的是哈希表。老的 SysV .hash 结构简单但链长;GNU 的 .gnu.hash 用了布隆过滤器 + 桶 + 链:
.gnu.hash 头:
  nbuckets    桶数量
  symoffset   第一个参与哈希的符号索引
  bloom_size  布隆过滤器字数
  bloom_shift 布隆哈希位移

布隆过滤器: 每个符号设置 2 个 bit
桶数组:    每个桶存符号索引
链数组:    冲突链
查找时先查布隆过滤器:如果两个 bit 都没置位,符号一定不存在,直接失败;如果置位,再按桶和链精确比较。绝大多数"不存在"的查询只需一次缓存访问就能否定,链接大量库时启动速度提升明显。
重定位表
$ readelf -rW libadd.so

Relocation section '.rela.dyn' at offset 0x408 contains 8 entries:
    Offset             Info             Type               Symbol's Value  Symbol's Name + Addend
0000000000003dd0  0000000000000008 R_X86_64_RELATIVE                         1050
0000000000003dd8  0000000000000008 R_X86_64_RELATIVE                         1040
0000000000003de0  0000000000000008 R_X86_64_RELATIVE                         2004
0000000000003de8  0000000000000008 R_X86_64_RELATIVE                         3e10
0000000000003ff0  0000000000000006 R_X86_64_GLOB_DAT      0000000000000000 _ITM_deregisterTMCloneTable + 0
0000000000003ff8  0000000000000006 R_X86_64_GLOB_DAT      0000000000000000 __gmon_start__ + 0
0000000000004000  0000000000000006 R_X86_64_GLOB_DAT      0000000000000000 _ITM_registerTMCloneTable + 0
0000000000004008  0000000000000006 R_X86_64_GLOB_DAT      0000000000000000 __cxa_finalize + 0

Relocation section '.rela.plt' at offset 0x4c8 contains 1 entry:
    Offset             Info             Type               Symbol's Value  Symbol's Name + Addend
0000000000004028  0000000000000007 R_X86_64_JUMP_SLOT     0000000000000000 _ZdlPv + 0
.rela.dyn 在加载时必须全部处理完,因为程序可能在任何时候访问这些数据。.rela.plt 可以延迟到第一次调用。两者的分工:
R_X86_64_RELATIVE:本地符号的绝对地址,加载时加基址。不需要查符号表,最快。R_X86_64_GLOB_DAT:外部数据符号的地址,填进 GOT。需要查全局符号表。R_X86_64_JUMP_SLOT:外部函数符号的地址,填进.got.plt。可以懒绑定。R_X86_64_IRELATIVE:IFUNC,调用一个函数来决定地址。R_X86_64_COPY:复制重定位,把数据从库复制到可执行文件的.bss。R_X86_64_TLSDESC/DTPMOD64/DTPOFF64:线程局部存储相关。
GOT 与 PLT 的实际内容
用 objdump -d -j .plt -j .text 看实际代码:
$ objdump -d -j .plt -j .text libadd.so

Disassembly of section .plt:

0000000000001020 <_init+0x20>:
    1020:   ff 35 f2 2f 00 00       push   QWORD PTR [rip+0x2ff2]   # 4018 <_GLOBAL_OFFSET_TABLE_+0x8>
    1026:   ff 25 f4 2f 00 00       jmp    QWORD PTR [rip+0x2ff4]   # 4020 <_GLOBAL_OFFSET_TABLE_+0x10>

0000000000001030 <_ZdlPv@plt>:
    1030:   ff 25 f2 2f 00 00       jmp    QWORD PTR [rip+0x2ff2]   # 4028 <_ZdlPv@got.plt>
    1036:   68 00 00 00 00          push   0x0
    103b:   e9 e0 ff ff ff          jmp    1020 <_init+0x20>

Disassembly of section .text:

0000000000001109 <_Z3addii>:
    1109:   lea    eax,[rdi+rsi*1]
    110c:   ret

000000000000111b <_Z3subii>:
    111b:   mov    eax,edi
    111e:   sub    eax,esi
    1121:   ret
_ZdlPv@plt 的 jmp 从 0x4028 取地址。这个地址在 .got.plt 里,初始值是 0x1036(push 指令的地址)。第一次调用时:
jmp跳到0x1036push 0压入重定位索引jmp 0x1020跳到 PLT0- PLT0 压入
link_map,跳到_dl_runtime_resolve - 解析完把真实地址写回
0x4028 - 跳到
operator delete
PLT0 的代码是:
0000000000001020 <_init+0x20>:
    1020:   ff 35 f2 2f 00 00       push   QWORD PTR [rip+0x2ff2]   # 4018 <_GLOBAL_OFFSET_TABLE_+0x8>
    1026:   ff 25 f4 2f 00 00       jmp    QWORD PTR [rip+0x2ff4]   # 4020 <_GLOBAL_OFFSET_TABLE_+0x10>
GOT 的前三项有固定含义:
GOT[0]:.dynamic的地址GOT[1]:link_map指针GOT[2]:_dl_runtime_resolve的地址
这就是为什么 .got.plt 的前三项在加载时就被填好,从第四项开始才是函数的跳转槽。
开启 -Wl,-z,now 后,.got.plt 在加载时全部填好,然后随 RELRO 一起变成只读,push 0 那段代码永远不会执行。可以用 readelf -d 里的 FLAGS_1: NOW 确认。
初始化与析构
.init_array 里存的是函数指针,加载器在重定位完成后依次调用。一个 C++ 动态库的典型内容:
$ readelf -x .init_array libadd.so
Hex dump of section '.init_array':
  0x00003dd0 70100000 00000000                    p.......
0x1070 是某个全局构造函数(或 frame_dummy)的地址。加载器处理 R_X86_64_RELATIVE 时把它加上基址,然后调用。
析构函数在 .fini_array,进程正常退出或 dlclose 时调用。顺序与构造相反:后构造的先析构。
注:
.init_array里的函数在main之前执行,此时其他库可能还没初始化。不要在全局构造函数里依赖尚未初始化的其他模块,也不要在里面创建线程或加载库。
符号版本
libstdc++ 这类库会同时提供多个版本的同一个符号。readelf --dyn-syms 里看到的 @GLIBCXX_3.4、@@CXXABI_1.3 就是版本标记。
- 单个
@:非默认版本,只能通过.symver显式引用 - 双
@:默认版本,普通引用会绑定到它
链接器用版本脚本给符号打版本:
MYLIB_1.0 {
    global:
        add;
        sub;
    local:
        *;
};
gcc -shared -fPIC -Wl,--version-script=libadd.map -o libadd.so.1.0.0 add.o这样 add 的符号名会变成 add@@MYLIB_1.0,其余符号全部隐藏。版本机制允许一个库里同时存在 add@MYLIB_1.0 和 add@MYLIB_2.0,老程序继续用旧版本,新程序用新版本——这是 ELF 解决"ABI 升级"问题的主要手段。
剥离与调试信息
一个未剥离的动态库包含 .symtab、.debug_*、.comment,体积可能是代码的几倍。strip 可以删掉它们:
strip --strip-unneeded libadd.so--strip-unneeded 只删"链接和加载不需要"的符号,.dynsym 会保留。如果直接 strip --strip-all,.dynsym 也会被删,动态库就废了。
保留调试信息但减小发布体积的做法:
objcopy --only-keep-debug libadd.so libadd.so.debug
strip --strip-unneeded libadd.so
objcopy --add-gnu-debuglink=libadd.so.debug libadd.so
发布时只带 libadd.so,调试时 GDB 会通过 .gnu_debuglink 找到 libadd.so.debug。
2.4 拆开一个 Windows DLL
PE 格式和 ELF 的思路相似,但组织方式不同。下面按加载器关心的顺序看。
整体结构
┌────────────────────────────┐
│ DOS 头(MZ)+ DOS 存根       │  兼容 DOS,存根打印 "This program cannot be run in DOS mode"
├────────────────────────────┤
│ PE 签名 "PE\0\0"            │
├────────────────────────────┤
│ COFF 文件头                  │  机器类型、节区数、时间戳、符号表指针
├────────────────────────────┤
│ 可选头(PE32 / PE32+)        │  入口点、ImageBase、节区对齐、数据目录
├────────────────────────────┤
│ 节区表                       │  每个节区的名字、大小、RVA、文件偏移、属性
├────────────────────────────┤
│ .text   代码                 │
│ .rdata  只读数据、导入表、导出表 │
│ .data   可写数据             │
│ .pdata  x64 异常展开信息      │
│ .reloc  基址重定位            │
│ .rsrc   资源                 │
│ .tls    TLS 目录和回调        │
│ .didat  延迟导入              │
└────────────────────────────┘
用 dumpbin /headers add.dll 可以看到可选头里的关键字段:
OPTIONAL HEADER VALUES
             20B magic (PE32+)
              8 major linker version
              E minor linker version
           1000 size of code
           1000 size of initialized data
              0 size of uninitialized data
           1010 address of entry point
           1000 base of code
        180000000 image base
           1000 section alignment
            200 file alignment
              6 subsystem (Windows CUI)
           1000 size of image
            400 size of headers
              0 checksum
              0 subsystem
           4160 DLL characteristics
                 High entropy VA
                 Dynamic base
                 NX compatible
Control Flow Guard- ImageBase:首选加载地址。EXE 默认
0x140000000(x64),DLL 默认0x180000000。如果这个地址被占用,加载器会重定位(前提是有.reloc)。 - SectionAlignment:内存里按 4KB 对齐;FileAlignment:文件里按 512 字节对齐。
- DLL characteristics:
Dynamic base表示支持 ASLR,NX compatible表示支持 DEP,Control Flow Guard表示启用 CFG。
数据目录
可选头后面跟着 16 个数据目录项,每项是"RVA + 大小":
| 索引 | 名称 | 作用 |
|---|---|---|
| 0 | Export | 导出表:本 DLL 提供哪些函数/数据 |
| 1 | Import | 导入表:本模块需要哪些 DLL 的哪些符号 |
| 2 | Resource | 资源(图标、字符串、manifest) |
| 3 | Exception | x64 异常展开信息(.pdata) |
| 4 | Security | 证书表(文件偏移,不是 RVA) |
| 5 | Base Reloc | 基址重定位表 |
| 6 | Debug | 调试信息 |
| 7 | Architecture | 保留 |
| 8 | Global Ptr | 全局指针 |
| 9 | TLS | 线程局部存储 |
| 10 | Load Config | 安全 Cookie、CFG、异常处理表 |
| 11 | Bound Import | 绑定导入(预解析地址) |
| 12 | IAT | 导入地址表 |
| 13 | Delay Import | 延迟导入 |
| 14 | CLR | .NET 元数据 |
| 15 | Reserved | 保留 |
导出表
导出表由 IMAGE_EXPORT_DIRECTORY 描述:
struct IMAGE_EXPORT_DIRECTORY {
    DWORD Characteristics;
    DWORD TimeDateStamp;
    WORD  MajorVersion;
    WORD  MinorVersion;
    DWORD Name;                  // DLL 名字的 RVA
    DWORD Base;                  // 序号基数
    DWORD NumberOfFunctions;     // 导出地址表项数
    DWORD NumberOfNames;         // 按名字导出的数量
    DWORD AddressOfFunctions;    // 导出地址表 RVA(每个是 RVA)
    DWORD AddressOfNames;        // 名字表 RVA(每个是字符串 RVA)
    DWORD AddressOfNameOrdinals; // 名字到序号索引的映射
};
三张表的关系:
AddressOfNames[i] ──> 字符串 "add"
AddressOfNameOrdinals[i] ──> 序号索引 j
AddressOfFunctions[j] ──> 函数 RVA
如果 AddressOfFunctions[j] 落在导出表自身的 RVA 范围内,它不是函数地址,而是一个转发器(forwarder)字符串,形如 KERNEL32.Sleep,表示"这个函数实际在另一个 DLL 里"。Windows 的 api-ms-win-* 和 kernel32 大量使用转发。
dumpbin /exports add.dll:
ordinal hint RVA      name

      1    0 00001010 add
      2    1 00001020 sub
ordinal 是序号,hint 是给加载器的提示(加快名字查找),RVA 是函数地址。
导入表
导入表是一个 IMAGE_IMPORT_DESCRIPTOR 数组,每个元素对应一个依赖 DLL:
struct IMAGE_IMPORT_DESCRIPTOR {
    union {
        DWORD Characteristics;
        DWORD OriginalFirstThunk;  // 指向 INT(导入名称表)
    };
    DWORD TimeDateStamp;
    DWORD ForwarderChain;
    DWORD Name;                    // DLL 名字的 RVA
    DWORD FirstThunk;              // 指向 IAT(导入地址表)
};- INT(Import Name Table,也叫 ILT):保存"要导入什么",每项指向
IMAGE_IMPORT_BY_NAME(hint + 名字)或直接用序号 - IAT(Import Address Table):加载器把解析出的真实地址写在这里
加载前,IAT 和 INT 内容相同;加载后,IAT 被改写为函数地址,INT 保持不变。
IAT:  [0x00007FF...add 的真实地址]   <-- 加载器写入
      [0x00007FF...sub 的真实地址]
INT:  [RVA -> "add"]
      [RVA -> "sub"]
调用 add 时,代码执行 call QWORD PTR [__imp_add],直接从 IAT 取地址。__imp_add 是导入库提供的符号,指向 IAT 中对应的槽位。
基址重定位
PE 文件里的绝对地址(比如全局指针的初始值)在加载到非首选基址时必须修正。.reloc 段就是为此存在的:
struct IMAGE_BASE_RELOCATION {
    DWORD VirtualAddress;   // 这一块的起始页 RVA
    DWORD SizeOfBlock;      // 块大小
    // 后面跟着 WORD 数组,每项高 4 位是类型,低 12 位是页内偏移
};
常见类型:
| 类型 | 值 | 含义 |
|---|---|---|
IMAGE_REL_BASED_ABSOLUTE |
0 | 填充,忽略 |
IMAGE_REL_BASED_HIGHLOW |
3 | 32 位绝对地址,加差值 |
IMAGE_REL_BASED_DIR64 |
10 | 64 位绝对地址,加差值 |
如果链接时用了 /FIXED,.reloc 会被删掉,文件变小,但 DLL 只能加载到首选基址。一旦被占用就加载失败。现代 Windows 默认开启 ASLR,DLL 必须保留重定位信息。
TLS 与延迟导入
TLS 目录(数据目录索引 9)描述线程局部存储的模板、索引、回调和大小。DLL 被加载时,加载器为每个线程分配 TLS 块,并调用 TLS 回调。
延迟导入(数据目录索引 13)让某个 DLL 在第一次调用它的函数时才加载,而不是启动时。它由 IMAGE_DELAYLOAD_DESCRIPTOR 描述,包含 DLL 名、IAT、INT、绑定的 IAT 等。MSVC 用 /DELAYLOAD:add.dll 加 delayimp.lib 开启。
静态库与导入库的区别
两种 .lib 的成员结构完全不同:
静态库 .lib |
导入库 .lib |
|
|---|---|---|
| 成员内容 | 真实 .obj |
存根 + 导入表片段 |
| 主要符号 | add、sub |
__imp_add、__IMPORT_DESCRIPTOR_add |
| 链接结果 | 代码被复制进 exe | exe 的导入表多一项 |
| 体积 | 较大 | 很小 |
| 生成方式 | lib /OUT |
链接 DLL 时自动生成,或 lib /DEF |
用 dumpbin /symbols add.lib 可以直接看到 __imp_ 前缀。
2.5 从文件结构反推链接过程
把上面的结构按"谁消费、做什么"整理成一张表:
| 文件结构 | 消费者 | 动作 |
|---|---|---|
| 静态库的符号索引 | 静态链接器 | 按未定义符号查表,取出成员 |
.o 的 .symtab |
静态链接器 | 建立全局符号表,检测重复定义 |
.o 的 .rela.* |
静态链接器 | 布局完成后填最终地址 |
.o 的 .group |
静态链接器 | COMDAT 去重,只保留一份模板实例 |
.so 的 .dynsym + .gnu.hash + .dynstr |
动态加载器 | 运行时按名字查找符号 |
.so 的 .dynamic |
动态加载器 | 读取依赖、soname、rpath、初始化数组 |
.so 的 .rela.dyn |
动态加载器 | 加载时填 GOT 和数据指针 |
.so 的 .rela.plt |
动态加载器 | 首次调用时填函数地址(懒绑定) |
.so 的 .plt |
CPU | 间接跳转存根 |
.so 的 .init_array |
动态加载器 | 调用全局构造函数 |
.so 的 PT_GNU_RELRO |
动态加载器 | 重定位后把敏感页改成只读 |
| PE 的导出表 | 其他模块的链接器/加载器 | 按名字或序号找到函数 RVA |
| PE 的导入表 + IAT | Windows 加载器 | 加载依赖 DLL,把地址写进 IAT |
PE 的 .reloc |
Windows 加载器 | 非首选基址时修正绝对地址 |
PE 的 .pdata |
异常分发器 | 栈展开,找到 catch 处理器 |
这张表也解释了两种库的本质差异:
- 静态库把"解析"留给静态链接器,文件里保留完整的符号表和重定位表
- 动态库把"解析"拆成两半:链接时解析结构,加载时解析地址
3. 几个问题
3.1 拆分库文件的意义
把代码拆成库,最直接的理由是复用,但真正让工程选择"拆"还是"不拆"的,是下面这几笔账。
复用与边界
一份实现只写一次,多个程序链接同一份库。修 bug 时只改一处,静态链接的程序重链后生效,动态链接的程序替换库文件后生效。
比复用更重要的是边界。头文件是接口,库是实现,两者之间隔着一条 ABI 合同。合同稳定,内部怎么重构都不会影响调用方;合同不稳定,改一个成员变量都可能让所有下游崩溃。库把"什么可以变、什么不能变"显式化了。
编译与增量构建
一个几十万行的项目,全量编译要几十分钟。拆成库之后,改一个模块只需要重编那个库,其他库和最终程序只做链接。头文件不变时,下游连编译都省了。
链接边界也常常是团队边界。A 组维护 libnetwork.a,B 组维护 librender.a,两边只要对齐头文件和 ABI,构建可以并行。
分发与更新
静态库把代码复制进最终产物,适合"发出去就不打算改"的工具、嵌入式固件、单文件绿色软件。动态库把代码留在外部,适合系统组件、插件、需要独立升级的模块。
许可证也是一个现实因素。LGPL 允许闭源程序动态链接 LGPL 库,但静态链接会触发"必须提供可重新链接的目标文件"等义务。商业项目在选择静态还是动态时,最好让法务看一眼。
体积与内存
这部分最容易产生误解,需要分开看"磁盘体积"和"物理内存"。
- 磁盘:静态链接把库代码复制进每个可执行文件。十个程序用同一个静态库,磁盘上就有十份。动态库只有一份,十个程序共享。
- 物理内存:动态库的代码页是文件页,多个进程映射同一个文件时,物理内存里只有一份;静态链接时,不同程序各自把同一份库代码复制进自己的可执行文件,这些副本位于不同文件,物理页不能跨程序共享(同一个可执行文件启动多个进程时,代码页仍然可以通过页缓存共享)。
- 虚拟内存:两者都按进程独立计算,动态库在每个进程里都占一段虚拟地址范围,但没访问的页不占物理内存。
对一个几十 MB 的 C++ 库,十个进程同时运行,动态库能省下的物理内存是实打实的;对一个几十 KB 的小库,这点差异可以忽略。
三种构建方式对比
用同一份代码做三个实验:
// add.h
#pragma once
int add(int a, int b);
// add.cpp
#include "add.h"
int add(int a, int b)
{
return a + b;
}// main.cpp
#include <cstdio>
#include "add.h"
int main()
{
std::printf("%d\n", add(2, 3));
return 0;
}方式 A:直接编译在一起
g++ -O2 main.cpp add.cpp -o app_direct方式 B:静态库
g++ -O2 -c add.cpp -o add.o
ar rcs libadd.a add.o
g++ -O2 main.cpp -L. -ladd -o app_static
方式 C:动态库
g++ -O2 -fPIC -c add.cpp -o add.o
g++ -shared -o libadd.so add.o
g++ -O2 main.cpp -L. -ladd -o app_shared
三者的产物:
$ ls -l app_direct app_static app_shared libadd.a libadd.so
-rwxr-xr-x 1 user user 16432 app_direct
-rwxr-xr-x 1 user user 16432 app_static
-rwxr-xr-x 1 user user 15984 app_shared
-rw-r--r-- 1 user user  1368 libadd.a
-rwxr-xr-x 1 user user 16008 libadd.so
app_direct 和 app_static 几乎一样大——静态链接之后,库代码就是程序的一部分,链接器甚至可能因为 add 很小而做内联。app_shared 略小,因为它不包含 add 的代码,但多了 PLT、动态段、导入元数据。libadd.so 自己也要占一份磁盘。
用 size 看节区:
$ size app_direct app_static app_shared libadd.so
   text    data     bss     dec     hex filename
   1580     608       8    2196     894 app_direct
   1580     608       8    2196     894 app_static
   1490     616       8    2114     842 app_shared
   1200     672       8    1880     758 libadd.so
注意 app_shared 的 text 比前两者小,但它的 .text 里没有 add,只有调用存根。
用 ldd 看依赖:
$ ldd app_direct
	linux-vdso.so.1 (0x00007ffd...)
	libc.so.6 => /lib/x86_64-linux-gnu/libc.so.6 (0x00007f...)
	/lib64/ld-linux-x86-64.so.2 (0x00007f...)

$ ldd app_static
	linux-vdso.so.1 (0x00007ffd...)
	libc.so.6 => /lib/x86_64-linux-gnu/libc.so.6 (0x00007f...)
	/lib64/ld-linux-x86-64.so.2 (0x00007f...)

$ ldd app_shared
	linux-vdso.so.1 (0x00007ffd...)
	libadd.so => not found
	libc.so.6 => /lib/x86_64-linux-gnu/libc.so.6 (0x00007f...)
	/lib64/ld-linux-x86-64.so.2 (0x00007f...)
app_shared 启动前必须能找到 libadd.so。方式 A 和 B 的可执行文件里没有这条依赖。
用 readelf -d 看动态段:
$ readelf -dW app_shared | head -n 8

Dynamic section at offset 0x2dd8 contains 27 entries:
  Tag        Type                         Name/Value
 0x0000000000000001 (NEEDED)             Shared library: [libadd.so]
 0x0000000000000001 (NEEDED)             Shared library: [libstdc++.so.6]
 0x0000000000000001 (NEEDED)             Shared library: [libc.so.6]
app_shared 记录了 libadd.so;app_static 没有这一项。
再看符号:
$ nm -D app_shared | grep _Z3addii
                 U _Z3addii
$ nm app_static | grep _Z3addii
0000000000001169 T _Z3addii
app_shared 里 add 是未定义的动态符号,靠 PLT 调用;app_static 里 add 是已定义的本地函数,直接调用。
把差异整理成表:
| 项目 | 直接编译 | 静态库 | 动态库 |
|---|---|---|---|
| 最终产物 | 一个 exe | 一个 exe | exe + .so |
| 库代码位置 | exe 内部 | exe 内部 | 独立的 .so |
| 符号解析 | 链接时 | 链接时 | 链接时 + 加载时 |
| 函数调用 | 直接 call | 直接 call | PLT/GOT 间接 |
| 跨翻译单元内联 | 可以(同一次编译) | 需要 LTO 才可以 | 通常不可以 |
| 启动开销 | 最小 | 最小 | 加载、重定位、符号解析 |
| 运行开销 | 最小 | 最小 | 间接跳转、GOT 访问 |
| 磁盘占用 | 每个 exe 一份 | 每个 exe 一份 | 多程序共享 |
| 物理内存 | 每个进程各自一份 | 每个进程各自一份 | 代码页可共享 |
| 更新方式 | 重新编译 | 重新链接 | 替换库文件(ABI 兼容) |
| 部署复杂度 | 低 | 低 | 需要带对库和搜索路径 |
| 运行时替换 | 不支持 | 不支持 | 支持(dlopen) |
| 典型问题 | 无 | 链接顺序、重复定义 | 找不到库、符号不匹配、ABI |
什么时候用哪种
- 单文件工具、嵌入式、启动时间敏感:静态链接。产物自包含,不怕目标机器缺库。
- 系统库、基础组件、多个程序共用:动态库。修一次,全系统生效。
- 插件、可选功能、热更新:动态库 + 运行时加载。
- C++ 项目内部模块:静态库组织代码,发布时链接成一个 exe 或一个动态库。开发时增量编译快,发布时接口少。
- 对外 SDK:C ABI 的动态库,配头文件和导入库;或者静态库 + 明确的编译选项。
- 需要跨编译器/跨语言:C ABI 动态库最稳;C++ ABI 跨编译器基本不可行。
注:静态库和动态库不是互斥的。一个项目可以同时生成
libfoo.a和libfoo.so,让使用者选。很多开源库默认两者都装,pkg-config --static给出静态链接所需的额外依赖。
3.2 动态库的数据加载
“动态库被加载"这句话经常被理解成"库里的数据被读进内存”。实际发生的事要细得多:哪些页共享、哪些页私有、什么时候发生页错误、重定位写在哪里,这些都直接影响程序的内存占用和启动行为。
进程地址空间中的库
一个 PIE 程序加载两个动态库后,虚拟地址空间大致是这样(地址是示意,每次运行都会因 ASLR 变化):
高地址
0x7ffffffff000  ┌────────────────────┐
                │ vDSO / vvar        │  内核映射的虚拟动态共享对象
0x7ffffffde000  ├────────────────────┤
                │ 栈(向下增长)        │  主线程栈,默认 8MB
                ├────────────────────┤
                │ ld-linux-x86-64.so │  动态加载器
                │ libstdc++.so.6     │  ┐
                │ libm.so.6          │  ├─ 共享库,随机基址
                │ libc.so.6          │  │
                │ libadd.so.1        │  ┘
                ├────────────────────┤
                │ 堆(向上增长)        │  malloc / new
                ├────────────────────┤
                │ .bss               │
                │ .data              │
                │ .rodata            │  exe 自身,PIE 随机基址
                │ .text              │
0x555555554000  └────────────────────┘
低地址
非 PIE 程序(-no-pie)的 exe 固定在 0x400000 附近,动态库仍然在高地址区。Windows x64 的布局形状类似,但具体区域不同:EXE 默认 0x140000000,DLL 默认 0x180000000,系统和第三方 DLL 通常被 ASLR 放到 0x7FF... 附近,栈和堆在低地址区。
关键点:每个动态库在每个进程里都占一段独立的虚拟地址范围,但它们的文件页可以映射到同一份物理内存。
段映射与页缓存
加载器对每个 PT_LOAD 段做一次 mmap:
mmap(base + p_vaddr, p_filesz,
     prot,                       // R / R+X / R+W
     MAP_PRIVATE | MAP_FIXED,    // 私有映射,固定地址
fd, p_offset);MAP_PRIVATE:写时复制。多个进程映射同一个文件页时,物理内存里只有一份,直到有人写。MAP_FIXED:把段映射到相对于基址的固定偏移,保证段之间的相对距离与链接时一致。p_filesz之后到p_memsz之间的部分(.bss)不来自文件,加载器补一段匿名零页。
mmap 只是建立映射,不会立刻读文件。第一次访问某一页时,CPU 触发缺页异常(page fault),内核把文件页读进页缓存(page cache),建立页表项,然后重新执行指令。
- 如果页已经在页缓存里(别的进程读过,或之前读过),这是次要缺页(minor fault),只建立映射,不读磁盘。
- 如果页不在页缓存里,这是主要缺页(major fault),需要读磁盘。
所以"程序启动慢"经常不是 CPU 慢,而是第一次加载大量库时发生了大量主要缺页。第二次启动会快很多,因为页缓存还在。
重定位写入与写时复制
加载器不是只做 mmap。它还要处理 .rela.dyn:
对每条 R_X86_64_RELATIVE:
    *(uint64_t*)(base + r_offset) = base + r_addend;

对每条 R_X86_64_GLOB_DAT:
    *(uint64_t*)(base + r_offset) = 查找符号地址();
这些写入落在 .data.rel.ro、.got、.init_array 等可写段里。第一次写入会触发写时复制(copy-on-write,COW):内核给这个进程分配一个私有物理页,把原页内容复制过去,然后修改页表指向新页。
结果是:
- 代码页(
.text):只读,从不被写,始终共享。 - 只读数据页(
.rodata):只读,始终共享。 - 需要重定位的只读数据(
.data.rel.ro、.got):加载时被写一次,变成私有脏页;之后被 RELRO 改成只读,但仍然是私有的。 - 可写数据页(
.data、.bss):每个进程一份,从来不共享。
所以"动态库的代码在内存里只有一份"这句话对,但"动态库的所有内容只有一份"不对。每个进程都有自己的全局变量、自己的 GOT、自己的构造函数状态。
哪些页共享,哪些页私有
| 区域 | 是否跨进程共享 | 说明 |
|---|---|---|
.text |
是 | 只读可执行,文件页,页缓存里一份 |
.rodata |
是 | 只读,文件页 |
.eh_frame |
是 | 只读,异常展开信息 |
.data.rel.ro |
否 | 加载时被重定位写过,COW 后私有 |
.got |
否 | 同上,RELRO 后只读但仍是私有页 |
.data |
否 | 可写全局变量,每个进程一份 |
.bss |
否 | 匿名零页,每个进程一份 |
.tdata |
否 | 每个线程一份 |
.tbss |
否 | 每个线程一份 |
从 CPU 与内存硬件看
把视角再往下压一层,动态库的加载和调用会碰到这些硬件行为:
1. 地址翻译与 TLB。 每次取指、读写数据,CPU 都要把虚拟地址翻译成物理地址。翻译结果缓存在 TLB(Translation Lookaside Buffer)里。TLB 是 per-core 的,进程切换时可能整体失效(现代 CPU 用 PCID 减少失效范围)。共享库的物理页可以跨进程共享,但 TLB 项不能——每个进程有自己的页表,也就有自己的翻译缓存。
2. 缺页与页错误。 加载器 mmap 之后并没有把代码读进内存。第一次执行某个代码页时触发缺页,内核把文件页放进页缓存、建立页表项,然后重新执行指令。一个大型 C++ 库启动时要触碰成百上千个页,缺页处理是启动时间的重要组成部分。第二次启动会快,因为页缓存还在。
3. 指令缓存。 代码页在物理内存里共享,L2/L3 通常是物理索引、物理标记的,多个进程执行同一个库时有机会命中同一份缓存行。L1i 是 per-core 的,进程切换后需要重新预热。PLT 存根、间接跳转、跨模块调用都会增加指令足迹,对 i-cache 不友好。
4. 分支预测。 直接 call 的目标在指令里,BTB(Branch Target Buffer)容易预测;PLT/IAT 的间接跳转要先读 GOT 再跳,预测器需要记住"这个槽位上次跳到哪"。Spectre 缓解措施(retpoline 等)会给间接跳转加开销,现代 CPU 的 eIBRS 等机制减轻了这部分影响,但跨模块调用始终比同模块直接调用多一层。
5. 对齐与缓存行。 PLT 项按 16 字节对齐,函数默认也按 16 字节对齐,目的是减少一条指令跨两个缓存行的情况。链接器在布局节区时会做对齐填充,这些填充也占文件体积。
6. 内存带宽与 NUMA。 多个进程同时启动、同时加载大量共享库时,缺页和页缓存读取会争抢磁盘 I/O 与内存带宽。在 NUMA 机器上,物理页可能分配在某个节点,跨节点访问延迟更高;共享库的代码页可能被多个节点上的进程同时使用,具体调度由内核决定。
注:这些硬件细节在不同微架构、不同内核版本上差异很大,不适合拿来估算具体数字。它们的价值在于解释"为什么第一次启动慢"“为什么跨模块调用有开销”"为什么大库对 i-cache 不友好"这类现象。
注:共享库的全局变量不是"跨进程共享内存"。两个进程加载同一个 DLL,各自的
g_count互不影响。需要跨进程共享数据时,要用共享内存(shm_open+mmap、CreateFileMapping+MapViewOfFile),而不是指望动态库的全局变量。
内存计量:RSS、PSS、USS
看一个进程用了多少内存,至少有三种口径:
- RSS(Resident Set Size):进程当前驻留在物理内存里的页数。共享页会被每个进程各算一次,所以多个进程的 RSS 相加会大于实际物理内存。
- PSS(Proportional Set Size):共享页按共享进程数均摊。一个页被 4 个进程共享,每个进程记 1/4 页。PSS 相加接近实际物理内存。
- USS(Unique Set Size):只算进程私有的页。进程退出时能真正释放的内存。
Linux 的 /proc/<pid>/smaps 给出每个映射的明细:
7f2b4c000000-7f2b4c021000 r-xp 00000000 08:01 1234567  /usr/lib/libc.so.6
Size:                132 kB
Rss:                 132 kB
Pss:                  12 kB
Shared_Clean:        132 kB
Shared_Dirty:          0 kB
Private_Clean:         0 kB
Private_Dirty:         0 kB

7f2b4c021000-7f2b4c023000 rw-p 00000000 08:01 1234567  /usr/lib/libc.so.6
Size:                  8 kB
Rss:                   8 kB
Pss:                   8 kB
Shared_Clean:          0 kB
Shared_Dirty:          0 kB
Private_Clean:         0 kB
Private_Dirty: 8 kB第一段是代码页,Shared_Clean 132 kB,PSS 只有 12 kB,说明大约有 11 个进程在共享它。第二段是可写数据页,Private_Dirty 8 kB,PSS 等于 RSS——完全私有。这就是前面"代码共享、数据私有"的量化证据。
pmap -x <pid>、smem、ps -o rss 都能看这些数字。Windows 上任务管理器的"工作集"对应 RSS,"专用工作集"对应 USS 的一部分;Process Explorer 和 VMMap 能看到更细的共享/私有划分。
线程与全局变量
同一个进程里的所有线程共享同一份动态库数据。库里的全局变量、静态变量、单例,对所有线程都是同一份。库作者必须自己保证线程安全:
// 错误:多线程下 data race
int counter = 0;

void increment()
{
    ++counter;
}
需要原子操作或锁。C++11 的 thread_local 给每个线程一份独立实例:
thread_local int counter = 0; // 每个线程各自一份线程局部存储
thread_local 在底层对应 ELF 的 TLS(Thread-Local Storage)。动态库里的 TLS 比可执行文件里的复杂,因为库可能在运行时才被 dlopen,线程数量在加载时已经确定。
TLS 有三种模型(x86-64):
| 模型 | 适用场景 | 访问方式 | 代价 |
|---|---|---|---|
local-exec |
可执行文件 | 固定偏移,直接访问 | 最低 |
initial-exec |
启动时加载的库 | 从静态 TLS 块取偏移 | 低,但 dlopen 可能失败 |
global-dynamic |
运行时加载的库 | 调用 __tls_get_addr |
较高 |
local-dynamic |
同一模块内 | 调用 __tls_get_addr,模块内缓存 |
中等 |
GCC 默认对动态库使用 global-dynamic,每次访问 TLS 变量都要调用 __tls_get_addr。如果确定库只在启动时加载,可以用 -ftls-model=initial-exec 把访问变成"静态 TLS 块 + 固定偏移",快很多。但 dlopen 这种库时,如果静态 TLS 空间不够,会报:
cannot allocate memory in static TLS blockglibc 预留了一块"静态 TLS 剩余空间"(GLIBC_TUNABLES=glibc.rtld.optional_static_tls=...),但预留给多少、够不够,取决于加载顺序和线程数。插件系统里这个错误很常见。
Windows 的 __declspec(thread) 由 PE 的 TLS 目录支持。Vista 之后,运行时加载的 DLL 也能使用线程局部变量;更早的 Windows 上则会失败。DLL 还可以注册 TLS 回调,在每个线程创建/销毁时执行。
加载、卸载与生命周期
dlopen 的引用计数:
void* h1 = dlopen("./libadd.so", RTLD_NOW | RTLD_LOCAL);
void* h2 = dlopen("./libadd.so", RTLD_NOW | RTLD_LOCAL);   // 同一路径,引用计数 +1,返回同一个句柄

dlclose(h1);    // 计数 -1,库还在
// ... 还能用 h2 里的函数 ...
dlclose(h2);    // 计数归零,析构函数执行,库被卸载
卸载时会发生什么:
.fini_array里的析构函数执行- 库的映射被解除
- 之后再调用库里的函数指针就是野指针
危险场景:
- 一个线程还在库的函数里,另一个线程
dlclose了库 → 代码页被解除映射,线程崩溃 - 库注册的回调还留在某个全局列表里 → 回调时跳进已卸载的地址
- 库的
thread_local对象析构顺序问题
RTLD_NODELETE 可以禁止卸载:
dlopen("./libadd.so", RTLD_NOW | RTLD_NODELETE);或者链接时加 -Wl,-z,nodelete。代价是库永远占着地址空间。
Windows 的 LoadLibrary / FreeLibrary 也是引用计数。FreeLibrary 递减到零时调用 DllMain(DLL_PROCESS_DETACH) 并卸载。如果某个线程正在 DLL 里执行,应该用 FreeLibraryAndExitThread 从 DLL 内部安全退出。
注:glibc 对含有
STB_GNU_UNIQUE符号的库可能拒绝卸载。C++ 头文件里的内联函数如果带函数内静态变量,GCC 会生成STB_GNU_UNIQUE符号,保证整个进程只有一份实例。这类库被dlclose后可能仍然留在内存里,用-fno-gnu-unique可以关闭这个行为。
Windows 的对应机制
Windows 加载器对 DLL 的处理与 ELF 类似,但术语不同:
- 用
NtMapViewOfSection把 DLL 的节区映射进进程地址空间 - 代码页和只读数据页是
MEM_IMAGE,多个进程共享同一份物理页 - 可写数据页是 COW,每个进程一份
- 加载器应用
.reloc重定位,把绝对地址加上基址差 - 加载器解析导入表,把函数地址写进 IAT(IAT 所在页因此变成私有)
- 最后调用
DllMain(DLL_PROCESS_ATTACH)
可以用 GetModuleHandle、GetModuleFileName、EnumProcessModules 遍历已加载模块。Process Explorer 的"DLL"页能看到每个进程加载了哪些 DLL、基址是多少。
3.3 dll 隔离
"DLL 隔离"这个词在不同语境下指不同的事,先把容易混淆的地方说清楚。
DLL 和 EXE 运行在同一个进程、同一个地址空间里。 加载一个 DLL 不是启动一个新进程,DLL 里的代码可以直接访问 EXE 传进来的指针,EXE 也可以直接调用 DLL 的函数。所谓"隔离",隔离的是模块级的数据、符号、版本和运行时状态,不是进程边界。
数据隔离
每个 PE 模块(EXE 或 DLL)都有自己的全局变量、静态变量和常量。即使两个模块定义了同名变量,它们也是不同的对象:
// exe.cpp
int g_state = 1;

// dll.cpp
int g_state = 2;    // 和 exe 里的 g_state 完全无关
这一点和静态链接不同。静态链接时,两个强定义同名全局变量会在链接阶段报 multiple definition;动态链接时,两个模块各自持有一份,链接器根本不会把它们放在一起比较。
后果是:
- DLL 里的单例、缓存、计数器,EXE 看不到也改不了,除非 DLL 显式导出访问函数
- 同一个 DLL 被加载一次,它的全局变量被所有调用方共享;不是每个调用方一份
- 如果同一个 DLL 被加载了两份(不同路径),会有两套全局变量,单例变成"双例"
符号隔离
Windows 的导入表把"我需要的符号"绑定到"某个具体 DLL":
app.exe 的导入表:
  add.dll  -> add, sub
  kernel32.dll -> Sleep, GetLastError
加载器按这张表逐个加载 DLL、逐个解析符号。解析范围是"目标 DLL 的导出表",不是全局命名空间。这意味着:
- 没有
LD_PRELOAD式的全局插入。你不能通过先加载一个同名函数的 DLL 来覆盖另一个 DLL 的内部调用。 - 两个 DLL 可以各自有内部函数
helper(),互不冲突,只要不导出。 - DLL 内部对自身函数的调用是直接的(或经过 IAT 但绑定到自己),不会被别的模块抢走。
Linux 的 ELF 模型相反:动态符号进入一个全局作用域,查找顺序是"主程序 → LD_PRELOAD → DT_NEEDED 顺序",先找到谁就用谁。库内部对自己全局函数的调用也可能被插入。两种模型各有代价:
- Windows 的隔离让模块行为可预测,但失去了运行时替换函数的灵活性
- ELF 的全局作用域支持
LD_PRELOAD、mock、诊断工具,也带来了符号冲突和意外插入
CRT 与堆隔离
这是 Windows 上最容易踩的坑之一。MSVC 的 C 运行时有两套链接方式:
| 选项 | 含义 | 堆 | CRT 状态 |
|---|---|---|---|
/MT / /MTd |
静态链接 CRT | 每个模块一份私有堆 | errno、strtok 状态、stdio 锁各自独立 |
/MD / /MDd |
动态链接 UCRT | 共享 ucrtbase.dll 的堆 |
全局共享 |
/MT 下,DLL 里 malloc 的内存拿到 EXE 里 free,是在两个不同的堆上操作,轻则崩溃,重则悄悄破坏堆结构。/MD 下,两边用同一个 UCRT 堆,malloc/free 可以跨边界,但前提是两边用的 UCRT 版本和编译选项一致。
Debug 和 Release 混用更危险:/MTd 和 /MT 是两个不同的 CRT,堆布局、调试填充、_ITERATOR_DEBUG_LEVEL 都不同。链接器通常会用 LNK2038 拦住:
LNK2038: 检测到"RuntimeLibrary"的不匹配: 值"MT_StaticRelease"不匹配值"MTd_StaticDebug"跨 DLL 传递 C++ 对象时,规则更严格。std::string 在 DLL 里构造、在 EXE 里析构,如果两边 CRT 不同,string 内部的堆指针会在错误的堆上释放。std::vector、std::shared_ptr、std::function 都有同样的问题。
实际工程的做法:
- 谁分配,谁释放。DLL 导出的创建函数配一个销毁函数,调用方不要直接
delete。 - 接口只用 C 类型。
char*、void*、固定宽度整数、不透明句柄;需要字符串时由调用方传缓冲区,或提供free_xxx。 - 统一 CRT。整个项目统一
/MD或/MT,Debug/Release 不混链。 - 需要跨边界传对象时,用 COM 的内存规则(
CoTaskMemAlloc/CoTaskMemFree)或自己实现 allocator 接口。
Linux 上这个问题通常小一些,因为整个进程共享同一个 glibc malloc。但以下情况仍会出问题:
- 某个库静态链接了自己的 libc 或用了自定义分配器(tcmalloc、jemalloc)
- 某个库静态链接了 libstdc++,和主程序的 libstdc++ 不是同一份
- 跨 DSO 传递
std::string,两边_GLIBCXX_USE_CXX11_ABI不一致
异常与 RTTI
C++ 异常跨 DLL 边界传播,依赖两边的运行时对栈帧布局、异常对象内存管理、类型信息比较达成一致。
Windows 上:
- 两边必须用兼容的 MSVC 工具集和 CRT(最好完全相同的版本)
- 异常类型需要在 DLL 里导出,否则 EXE 可能捕获不到
/EHsc、/EHa等异常模型要一致/MT下每个模块有自己的type_info对象,跨模块catch依赖运行库按名字比较;不同编译器/版本之间不要依赖这个行为
Linux 上:
type_info符号是弱符号,动态加载器会把多个 DSO 里的同名 typeinfo 合并成一份,所以catch通常能跨 DSO 工作- 但如果类被
-fvisibility=hidden隐藏,它的 typeinfo 也变成隐藏符号,不再参与合并,跨 DSO 的catch和dynamic_cast可能失败 - 异常类的定义必须一致(ODR),否则 typeinfo 的名字虽然一样,布局却不同
跨 C ABI 边界抛 C++ 异常是未定义行为。C 代码不知道 __cxa_throw、_Unwind_RaiseException 这些机制,也没有对应的栈展开信息。要用 C ABI 导出,就在边界内把异常转成错误码。
版本隔离与 DLL 地狱
Windows 早期的 DLL 版本管理很简单:DLL 放在 System32 或应用目录,按名字查找。两个程序需要同一个 DLL 的不同版本时,后安装的会覆盖先安装的,先安装的程序就坏了。这就是DLL 地狱(DLL hell)。
微软的解决方案是并行程序集(Side-by-Side Assembly,SxS):
- 每个程序带一个 manifest,声明它需要哪个版本、哪个架构的 CRT/组件
- 组件装在
WinSxS目录下,按版本和架构分开存放 - 加载器根据 manifest 创建激活上下文(activation context),在隔离的命名空间里查找 DLL
- 不同版本可以真正并存,互不覆盖
Linux 的对应机制是 soname + 符号版本:
libfoo.so.1和libfoo.so.2可以同时安装,因为文件名不同- 程序链接时记录
DT_NEEDED: libfoo.so.1,运行时按名字找,不会误加载.so.2 - 同一个 soname 内,用符号版本区分
foo@VER_1和foo@@VER_2,老程序继续绑定旧版本
两者解决的思路不同:Windows 用 manifest 和目录隔离,Linux 用文件名和符号版本。共同点是:版本信息必须写进二进制,不能靠安装顺序。
搜索路径隔离与劫持
DLL 的搜索顺序本身就是一个安全问题。Windows 默认(SafeDllSearchMode 开启):
- 应用程序所在目录
System32- 16 位系统目录
- Windows 目录
- 当前工作目录
PATH环境变量里的目录
如果程序用 LoadLibrary("add.dll") 而不是完整路径,攻击者可以把恶意 add.dll 放到当前目录或 PATH 里靠前的位置,程序就会加载它。这就是 DLL 劫持(DLL hijacking)。
缓解手段:
// 只从 System32 和应用程序目录搜索
SetDefaultDllDirectories(LOAD_LIBRARY_SEARCH_SYSTEM32 | LOAD_LIBRARY_SEARCH_APPLICATION_DIR);

// 或者用完整路径 + 安全搜索标志
LoadLibraryExW(L"C:\\Program Files\\MyApp\\add.dll", nullptr,
LOAD_LIBRARY_SEARCH_DLL_LOAD_DIR | LOAD_LIBRARY_SEARCH_SYSTEM32);其他措施:AddDllDirectory 添加可信目录、/DEPENDENTLOADFLAG 设置依赖 DLL 的默认搜索标志、KnownDlls 注册表项、DLL 签名校验。
Linux 的对应问题:
LD_LIBRARY_PATH会覆盖 rpath/runpath,被恶意设置时会加载错误库- 当前目录默认不在搜索路径里(除非 rpath 写了
.),所以"当前目录劫持"比 Windows 少 LD_PRELOAD是双刃剑:诊断和 mock 很有用,也是注入手段- setuid 程序会忽略
LD_LIBRARY_PATH和不可信目录的 rpath,这是安全设计
容器部署里常见的问题是"构建环境和运行环境的 glibc 版本不一致":
./app: /lib/x86_64-linux-gnu/libc.so.6: version `GLIBC_2.34' not found解决办法是在较老的发行版上构建,或者静态链接 libc(如果许可证和功能允许),或者把运行环境对齐。
同名模块与双份加载
Windows 加载器以模块名识别 DLL。同一个进程里,同名 DLL 通常只加载一份。这带来两个后果:
- 两个不同路径下的同名 DLL,后一个
LoadLibrary可能直接返回已加载模块的句柄,你以为什么都没发生 - 想同时用两个版本,必须用 SxS 或改文件名
Linux 的 dlopen 按路径和文件身份(device + inode)识别。同一个文件通过符号链接打开多次,只会加载一份;两个不同路径的副本,会加载两份。两份同名库会带来:
- 两套全局变量和单例
- 两套 RTTI,跨库
dynamic_cast失败 - 符号插入顺序不确定,内部调用可能绑到另一份
这类 bug 往往表现为"有时候对,有时候错",因为加载顺序受环境影响。
隔离的代价
模块隔离不是免费的:
- 不能跨边界内联。DLL 导出的函数,调用方只能通过 IAT/PLT 间接调用,编译器不能把函数体内联进来。除非用 LTO/IPO 或把实现放进头文件。
- 接口必须显式。Windows 必须导出符号,Linux 虽然默认全导出,但为了 ABI 稳定通常也要收窄。
- ABI 必须稳定。类布局、虚表、STL 类型、异常模型都不能随便改。
- 全局状态重复。每个模块一份,注册表、日志器、配置缓存都要考虑"哪个模块的"。
- 初始化顺序。DLL 的
DllMain在加载器锁下执行,不能做重活;多个 DLL 的初始化顺序由依赖决定,不要依赖未声明的顺序。 - 调试更难。符号、加载地址、模块版本、搜索路径,任何一项不对都可能导致"在我机器上能跑"。
设计稳定 ABI 的规则
如果库要给别人用,尤其是跨编译器、跨语言、跨版本,按下面的规则设计接口:
- 导出 C ABI。用
extern "C"关闭名称修饰;需要重载时用不同函数名。C ABI 的调用约定、名字规则最稳定。 - 不透明句柄。不要暴露结构体布局,导出
create_xxx/destroy_xxx,句柄用typedef struct xxx* xxx_t;。 - 固定宽度类型。用
int32_t、uint64_t,不要用long(Windows 上是 32 位,Linux 64 位上是 64 位)。 - 显式大小和版本。结构体第一个字段放
size或version,方便未来扩展。 - 内存所有权明确。谁分配谁释放,提供配套的释放函数;需要调用方分配时传缓冲区。
- 异常不跨边界。C ABI 函数内部捕获所有异常,返回错误码。
- 不导出类。导出类会把 vtable 布局、内联函数、RTTI、STL 成员全部暴露成 ABI 的一部分。用工厂函数 + 抽象接口替代。
- 收窄符号可见性。Linux 用
-fvisibility=hidden+ 显式visibility("default");Windows 用.def或__declspec(dllexport)精确控制。 - 版本化。Linux 用 soname + 符号版本;Windows 用文件名、manifest、导出序号。
- 用工具检查。
abidiff、abi-compliance-checker、dumpbin /exports对比新旧版本,CI 里跑一遍。
3.4 库的依赖与链接顺序
静态库的依赖图
静态库之间可以互相依赖。liba.a 里的 a.o 引用了 libb.a 里的 b(),链接时两个库都要出现在命令行上,而且顺序要对:
gcc main.o -la -lb -o appGNU ld 从左到右扫描:-la 取出 a.o,引入未定义符号 b;-lb 取出 b.o,解析 b。反过来写,-lb 先被扫描时还没有人需要 b,b.o 不会被取出;等 -la 引入 b 时,-lb 已经过去了。
循环依赖:
liba.a -> libb.a -> liba.a用 --start-group:
gcc main.o -Wl,--start-group -la -lb -Wl,--end-group -o appMSVC 的 link.exe 对库顺序的敏感度通常比 GNU ld 低,很多时候不需要手动分组,但显式写出顺序仍然更安全。
动态库的传递依赖
动态库的依赖记录在自己的 DT_NEEDED 里,链接可执行文件时,链接器会读取这些信息来检查符号,但不一定会把传递依赖写进可执行文件。
# liba.so 依赖 libb.so
gcc main.o -la -o app
如果 main.o 直接用了 libb.so 的符号,现代 ld 默认要求显式写 -lb(--no-copy-dt-needed-entries 是默认行为)。如果不写,可能报 undefined reference,也可能在运行时才发现。
-Wl,-rpath-link,/path/to/libb 告诉链接器去哪里找传递依赖,只影响链接阶段,不影响运行时。
--as-needed 与 DT_NEEDED
很多发行版的 GCC 默认开启 --as-needed:只有当可执行文件真正引用了某个库的符号时,才把该库写进 DT_NEEDED。
gcc main.o -lfoo -lbar -o app如果 main.o 只用了 foo,bar 不会出现在 DT_NEEDED 里。这能减少不必要的运行时依赖,但也带来两个坑:
- 库的作用只是"被加载时执行构造函数"(插件注册、日志初始化),没有任何符号被引用 → 被丢弃。解决:
-Wl,--no-as-needed放在该库前面。 - 库的顺序影响
--as-needed的判断。-lbar -lfoo和-lfoo -lbar可能产生不同的DT_NEEDED。
gcc main.o -Wl,--no-as-needed -lbar -Wl,--as-needed -lfoo -o app符号冲突与 ODR
静态链接时,符号冲突在链接阶段暴露:
- 两个强定义 →
multiple definition - 强定义 + 弱定义 → 强定义胜出
- 两个弱定义 → 先看到的胜出
- COMDAT 组 → 链接器只保留一份,要求各份内容一致
动态链接时,冲突被推迟到运行时,而且不会报错:
- 两个 DSO 导出同名符号 → 全局作用域先到先得,后加载的绑定到先加载的
- 两个 DSO 各自内部调用同名函数 → 可能都绑到第一个,取决于是否用了
-Bsymbolic或隐藏可见性 - 两个 DSO 包含同名内联函数但实现不同 → ODR 违反,行为未定义
ODR 违反最难查。两个库用不同编译选项(-DNDEBUG、_GLIBCXX_USE_CXX11_ABI、_ITERATOR_DEBUG_LEVEL)编译同一个头文件里的内联函数,链接器只会保留一份,另一份的调用方拿到的是错误实现。表现可能是"Debug 版正常,Release 版崩",或者反过来。
排查手段:
nm -D --defined-only libfoo.so | c++filt | sort > foo.syms
nm -D --defined-only libbar.so | c++filt | sort > bar.syms
comm -12 foo.syms bar.syms      # 两边都导出的同名符号
如果两个库本不该共享符号,用 -fvisibility=hidden 和版本脚本把它们藏起来。
3.5 库的版本与 ABI
API 与 ABI
- API:源码层面。函数签名、类型、宏、模板、语义。API 兼容意味着老代码不改就能重新编译。
- ABI:二进制层面。调用约定、寄存器分配、结构体布局、名字修饰、虚表布局、异常传播、内存分配器。ABI 兼容意味着老二进制不改就能直接跑在新库上。
源码兼容不等于二进制兼容。给类加一个成员变量,源码改不改都能编译,但所有依赖这个类布局的二进制都得重编。
soname 的三层命名
Linux 上一个规范的共享库有三个名字:
libfoo.so.1.2.3     真实文件(real name),带完整版本号
libfoo.so.1          soname,主版本号,链接时记录到 DT_NEEDED
libfoo.so            链接名(linker name),开发时 -lfoo 找的就是它
目录结构:
/usr/lib/libfoo.so      -> libfoo.so.1
/usr/lib/libfoo.so.1    -> libfoo.so.1.2.3
/usr/lib/libfoo.so.1.2.3
libfoo.so 由 -dev 包提供,只在编译时需要;运行时只需要 libfoo.so.1。
链接时用 -Wl,-soname,libfoo.so.1 设置 soname。升级规则:
- ABI 兼容的修改(修 bug、加新符号)→ 保留 soname,只改小版本号
- ABI 不兼容的修改(删符号、改布局、改签名)→ 提升 soname 到
libfoo.so.2,两个版本可以并存
符号版本
soname 只能区分"大版本"。同一个 soname 内,如果某个函数的 ABI 变了,可以用符号版本:
foo@VER_1     老版本,非默认
foo@@VER_2    新版本,默认
老程序链接时记录 foo@VER_1,运行时仍然绑定到老实现;新程序默认绑定 VER_2。glibc 和 libstdc++ 大量使用这个机制,所以你能看到 GLIBC_2.2.5、GLIBCXX_3.4.29 这样的版本串。
版本脚本的写法:
VER_1 {
    global:
        foo;
        bar;
    local:
        *;
};

VER_2 {
    global:
        foo;
        baz;
} VER_1;
VER_2 继承 VER_1,foo 在 VER_2 里变成默认版本,bar 继续留在 VER_1。
Windows 的版本策略
Windows 没有 soname,导入表直接记录 DLL 文件名。版本管理靠:
- 文件名带版本:
foo-1.2.dll、foo-2.0.dll - 导出序号:老客户端按序号导入,新版本保持序号不变
- manifest / SxS:声明依赖的具体版本
- API Sets:
api-ms-win-core-file-l1-1-0.dll这样的逻辑名,实际实现由系统转发
导出序号是一把双刃剑。按名字导入时,加新函数不影响老客户端;按序号导入时,序号一旦变化,老客户端会调到错误的函数。所以成熟库通常固定序号,只在末尾追加。
哪些改动会破坏 ABI
C++ 库里,下面这些改动几乎一定会破坏 ABI:
- 增加、删除、重排虚函数
- 增加、删除、重排成员变量
- 改变成员类型、对齐、packing
- 改变类的大小或继承关系
- 改变函数签名、返回类型、调用约定
- 改变
noexcept、const、引用限定符 - 改变枚举的底层类型
- 改变内联函数的实现(ODR)
- 改变模板的实例化结果
- 改变异常模型(
-fno-exceptions) - 改变 RTTI 开关(
-fno-rtti) - 改变标准库 ABI(
_GLIBCXX_USE_CXX11_ABI、_ITERATOR_DEBUG_LEVEL) - 改变 CRT 链接方式(
/MTvs/MD) - 改变编译器版本(MSVC 的 STL 布局随版本变化)
相对安全的改动:
- 增加非虚成员函数(不影响布局和虚表)
- 增加静态成员
- 增加新的全局函数或重载
- 修改函数体(不改变签名和语义契约)
- 增加新的类
即便如此,"相对安全"也要用工具验证。人眼很难判断一个改动是否改变了布局,尤其是涉及继承、虚继承、空基类优化、[[no_unique_address]] 的时候。
保持 ABI 稳定的做法
- Pimpl:把实现藏在
std::unique_ptr<Impl>里,头文件只暴露指针。成员变量怎么改都不影响类大小。 - 纯虚接口 + 工厂:导出
create()返回IInterface*,调用方只看到虚表指针。 - C ABI:最稳,跨编译器、跨语言、跨版本。
- 版本脚本/导出列表:只导出公开符号,内部符号隐藏,减少 ABI 表面积。
- ABI 检查工具:
abidiff、abi-compliance-checker、abi-dumper在 CI 里对比旧版本。 - 语义化版本:MAJOR 变更才允许 ABI 破坏,MINOR 只加不改,PATCH 只修 bug。
- 同时安装多版本:Linux 用 soname,Windows 用 SxS 或文件名。
注:
_GLIBCXX_USE_CXX11_ABI是 GCC 5 引入的双 ABI 机制。std::string和std::list的新实现放在std::__cxx11命名空间里,符号带__cxx11后缀。用-D_GLIBCXX_USE_CXX11_ABI=0可以和老库互操作,但同一个进程里不能混用两种 ABI 的std::string。这是很多"升级 GCC 后链接不上"问题的根源。

