
内存基础
1. 进制
在基数为 R 的进制中,包含 R 个数字符号, 分别是 0, 1, 2, …, R-1 一个整数n位、小数m位的R进制数字,可以表示为:
其中, 是第 位上的数字符号,满足 。 同时,也可以用连加符号来表示:
1.1 二进制
二进制是基数为 2 的进制系统,使用两个数字符号:0 和 1。每一位上的权重是 2 的幂次方。
如:
1.2 八进制、十六进制与二进制的换算
八进制和十六进制是计算机常用的进制。
- 八进制(Oct,简写O):使用八个数字符号:0, 1, 2, 3, 4, 5, 6 和 7。
- 十六进制(Hex,简写H):使用十六个数字符号:0, 1, 2, 3, 4, 5, 6, 7, 8, 9, A, B, C, D, E 和 F。
由于 和 ,八进制和十六进制的每一位可以直接对应二进制的三位和四位:
八进制:
0 = 0b000  1 = 0b001  2 = 0b010  3 = 0b011
4 = 0b100  5 = 0b101  6 = 0b110  7 = 0b111

十六进制:
0 = 0b0000  1 = 0b0001  2 = 0b0010  3 = 0b0011
4 = 0b0100  5 = 0b0101  6 = 0b0110  7 = 0b0111
8 = 0b1000  9 = 0b1001  A = 0b1010  B = 0b1011
C = 0b1100  D = 0b1101  E = 0b1110  F = 0b1111
2. 比特、字节与字
- 比特(bit):计算机的最小数据单位,只有两个取值:0或1
- 字节(Byte):一个字节由8个比特组成,即
1Byte = 8bit - 字(Word):计算机进行数据处理和存储时,作为一个单元的一组二进制数位。
- 字的长度(即一个字包含的比特位数)取决于计算机的硬件架构。早期16位计算机系统中,一个字是16比特位,在现在的32位和64位计算机系统中,一个字分别是32比特和64比特。
- 计算机的 CPU 在处理数据时,通常以字为单位进行操作。较大的字长意味着 CPU 一次能够处理更多的数据,从而提高计算机的运算速度和效率
3. 内存与地址
- 内存是计算机中用于暂时存储数据和程序的部件,当你打开一个程序,程序及其相关数据就会被加载到内存中,CPU 才能对它们进行处理。
- 内存地址:内存地址是内存中每个存储单元(每个字节)的唯一编号,CPU通过地址获取数据存储在内存中的位置,进而进行读写操作。
注:对于32位系统,由于地址总线宽度为 32 位,我们用 32 个二进制位来表示地址,通常写成十六进制也就是 0x00000000 到 0xFFFFFFFF 的形式。类似地,64位系统用 64 个二进制位来表示地址,通常写成十六进制也就是 0x0000000000000000 到 0xFFFFFFFFFFFFFFFF 的形式。
C++的内存结构:
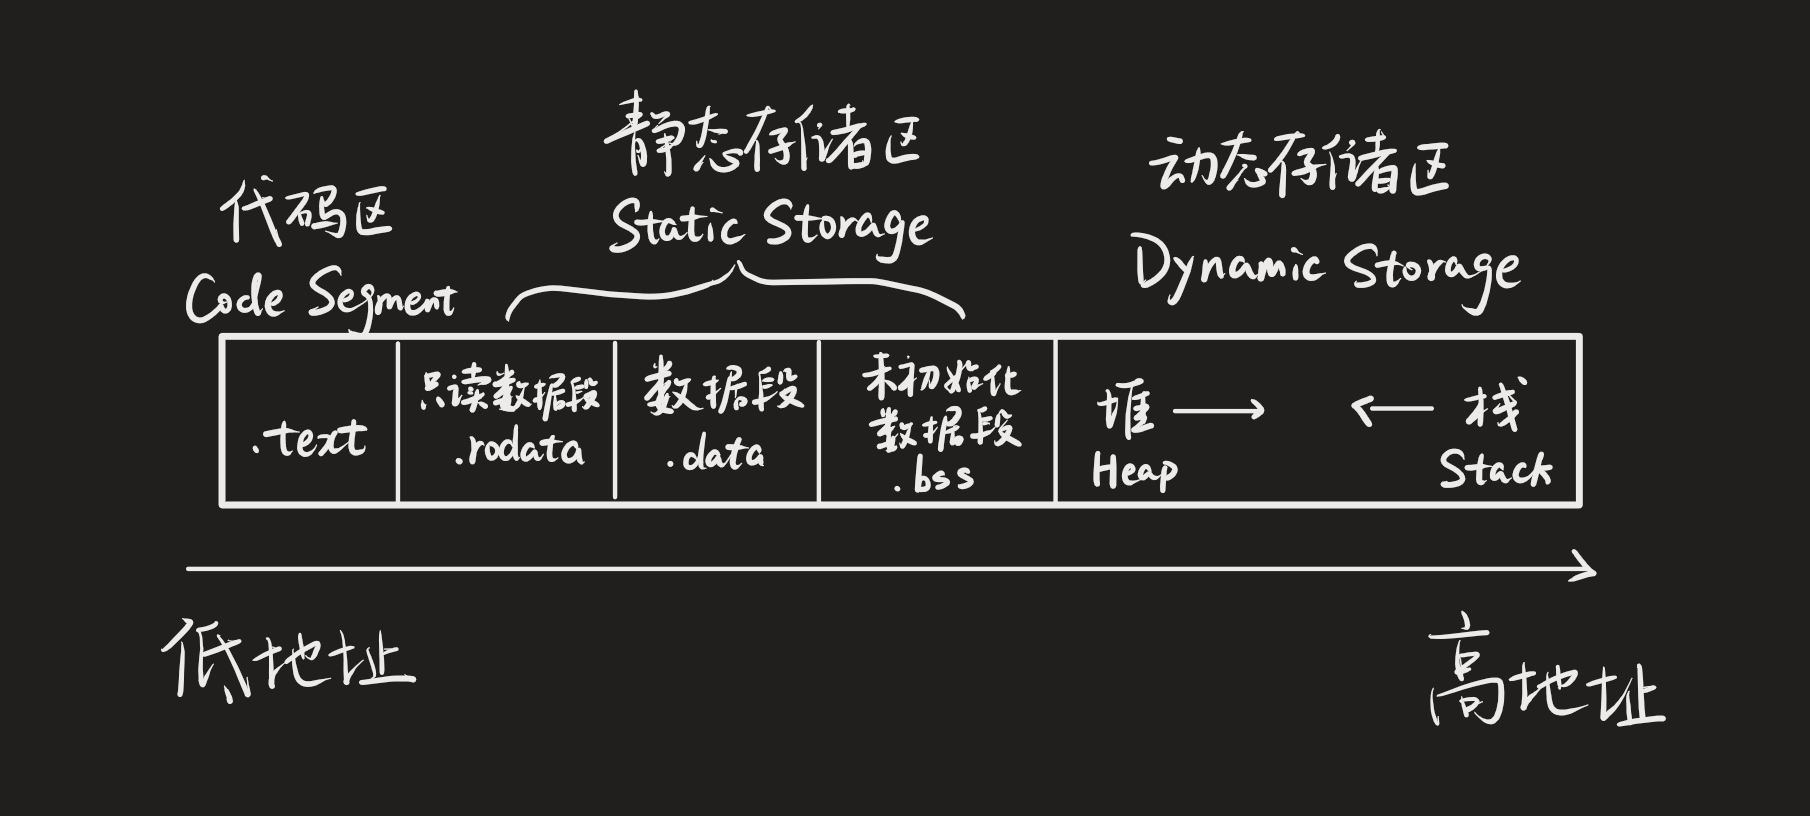
3.1 C++进程的内存布局
- 代码段 (
.text):编译后的机器指令、函数代码,只读共享 - 常量段 (
.rodata):字符串字面量、const全局常量,只读 - 全局 / 静态数据段 (
.data/.bss).data:初始化全局变量、静态局部变量.bss:未初始化全局 / 静态变量,程序启动清零
- 堆 (
Heap) - 共享库、内存映射区域
- 栈 (
Stack)(每个线程独立栈) - 内核空间(用户程序不可访问)
其中,堆和栈是程序运行时动态分配的内存区域。堆用于动态分配内存,从低地址往高地址增长;而栈用于函数调用和局部变量的存储,从高地址往低地址增长;两者中间留大片空闲虚拟内存,避免碰撞。
3.2 栈的管理规则
- 操作系统预先分配固定大小:Windows 默认 1MB,Linux 默认 8MB,编译链接时可改栈大小
- 自动生命周期:进入函数分配栈帧,函数 return 自动销毁栈帧,无需手动释放
- 分配极快:只修改栈寄存器 rsp/sp,无系统调用
- LIFO 后进先出,栈帧连续内存,无碎片
- 缺点:空间极小,大数组、深度递归会触发 栈溢出 Stack Overflow
3.3 堆的管理规则
- 空间巨大:使用进程剩余虚拟内存,上限由操作系统 / 物理内存限制
- 手动管理:
- C:malloc 申请,free 释放
- C++:new 申请,delete 释放;忘记释放造成内存泄漏;重复释放、野指针崩溃
- 分配慢:需要堆管理器查找空闲块、维护链表元数据,频繁分配释放产生内存碎片
- 生命周期不受函数限制:函数退出堆内存不会自动销毁,必须手动释放
- 进程全局共享,所有线程共用同一块堆,并发分配需要加锁,存在竞争
相关推荐

2026-07-27
if 语句
需要预先学习: 表达式与基础语句 能作为条件的表达式 在 C++ 中,条件就是放在 if、while 等控制结构里用来决定程序走向的表达式。条件表达式的类型是 bool 类型,值只能是 true(真)或 false(假)。 bool flag = true; // flag 的值为 true if (flag) // flag 是 bool 类型,直接作为条件 { // 条件成立时执行 } 关系表达式 关系表达式使用关系运算符比较两个值的大小或相等关系,结果是 bool 类型。 运算符 含义 示例 结果 > 大于 a > b a 大于 b 则为 true < 小于 a < b a 小于 b 则为 true >= 大于等于 a >= b a 大于等于 b 则为 true <= 小于等于 a <= b a 小于等于 b 则为 true == 等于 a == b a 等于 b 则为 true != 不等于 ...
2026-07-22
数组名退化为指针
需要预先了解: 数组 指针 数组到指针的退化 数组名出现在大多数表达式中,会被编译器自动转化为指向数组首元素的指针: int arr[5] = { 1, 2, 3, 4, 5 }; int* p = arr; // arr 这里的含义为 &arr[0],类型为 int* 1. 下标访问arr[i]在底层等价于*(arr + i) 甚至可以可以有3[arr]这样的写法,和arr[3]等效: #include <iostream> int main() { int arr[5] = { 1, 2, 3, 4, 5 }; std::cout << 3[arr] << std::endl; // 并不建议的写法 return 0; } 2. 可以用指针的方式访问数组,或用数组的方式访问指针 #include <iostream> int main() { int arr[5] = { ...
2026-09-03
多线程编程基础
基础概念 多线程编程之前,先搞清楚几个基本概念:并发、并行、进程、线程、协程。它们经常被混用,但含义差别很大,而且这些差异最终都落在硬件层面。 并发与并行 并发(concurrency)指多个任务在同一时间段内交替推进——宏观上看它们"同时"在进行,微观上可能只有一个执行单元在轮流处理。并行(parallelism)指多个任务在同一时刻真正同时执行,这要求有多个执行单元(多个 CPU 核心)。 两者的关系可以用一个经典表述概括:并发是程序结构层面的性质,并行是执行层面的性质。一个程序可以设计成并发的(多个任务交替推进),但只有在多核机器上运行时才可能并行。 单核并发(时间片轮流): CPU 核心: [任务A][任务B][任务A][任务B][任务A][任务B] ... └── 每个时刻只有 1 个任务在跑 ──┘ 双核并行: 核心 1: [任务A][任务A][任务A][任务A] ... 核心 2: [任务B][任务B][任务B][任务B] ... └── 同一时刻有 2 个任务在跑 ──┘ 注意:并发程序...
2026-07-26
引用与指针的区别
需要预先学习: 指针 指针常量与常量指针 引用与左右值 语法层面 指针的值是地址,需要通过解引用操作符*来访问指针所指向的对象,而引用是一个已存在变量的别名,可以直接使用引用名来访问变量。 int num = 10; int* ptr = # int& ref = num; std::cout << *ptr << std::endl; std::cout << ref << std::endl; 资源持有层面 引用天然地不支持更换对象,而指针需要在*后加const修饰才能实现类似语义: int& ref = num; // ref 永远绑定 num ref = num2; // 这是把 num2 的值赋给 num,而不是让 ref 绑定 num2 // 相当于: int* const ptr = # // ptr 永远指向 num 内存层面 引用在一些实现中不占用额外的内存空间,而指针是一个变量,会占用一定的...
2026-07-22
标识符
标识符 标识符(identifier):在程序中用来充当变量、函数、类等的名字。 标识符的命名规则 1.标识符只能由字母、数字和下划线组成,并且必须以字母或下划线开头。 int myVariable = 10; // 正确,myVariable 以字母开头 int _myVariable = 20; // 正确,_myVariable 以下划线开头 int myVariable2 = 40; // 正确,可以包含数字 int 2myVariable = 30; // 错误,可以包含数字但不能以数字开头 int my-Variable = 40; // 错误,标识符中不能包含其它字符 2.标识符不能是 C++ 的关键字。 这里 C++ 的关键字不需要特殊记忆,因为在编程过程中会经常接触到它们,自然而然就会记住它们了。 int int = 10; // 错误,int 是 C++ 的关键字 int while = 20; // 错误,while 是 C++ 的关键字 int...
2026-09-05
CRTP(奇异递归模板模式)
需要预先学习: 模版基础 继承 多态 CRTP(奇异递归模板模式) CRTP(Curiously Recurring Template Pattern,奇异递归模板模式)是一种继承写法:派生类把自己作为模版参数传给基类。 template <typename Derived> class Base { // 基类通过模版参数 Derived "知道"派生类是谁 }; class Widget : public Base<Widget> // Widget 把自己传给 Base { }; 这样基类在编译期就知道"谁继承了我",可以直接使用派生类的类型——由此得到一类不依赖 virtual 的多态能力,称为静态多态(static polymorphism,编译期多态)。 最小示例 #include <iostream> template <typename Derived> class Base { public: void inter...
